Я создал модель синтеза речи для хорватского языка на 32 млн параметров. Сравниваю голоса по ходу обучения
Вслед за LLM для RAG на хорватском языке я решил создать небольшую модель синтеза речи (TTS) специально для хорватского языка. Цель — работа в реальном времени на CPU смартфона.
Я использовал дистилляцию: большая модель синтеза речи (HiggsAudio v3) начитывала хорватские сценарии, создавая обучающие данные, на которых затем с нуля обучалась маленькая модель. Сначала я провёл пилотное обучение на 7,5 часа данных и сравнил, как меняется одна и та же фраза по мере обучения.
Сразу к выводам.
- При 32 млн параметров (Matcha-TTS — 18,3 млн + Vocos — 13,5 млн) модель действительно заговорила по-хорватски
- Уже через 50 минут обучения (5 000 шагов) она читала строго по сценарию. Дальше улучшался главным образом «шум»
- Финальная частота символьных ошибок на 14 оценочных фразах составила 0,9% (10 из 14 фраз совпали полностью)
- Даже на одном потоке CPU можно было сгенерировать 1 секунду речи за 0,09 секунды (i7-13700K)
Демонстрация: заставим её говорить
На песочнице хорватского TTS размещена модель из этой статьи — финальная версия на 30 000 шагов. Введите любой хорватский текст, и она озвучит его прямо на месте.
- Можно выбрать один из 50 примеров (приветствия, путешествия, больница и т. д.) или ввести до 1 000 символов своего текста
- Можно менять скорость речи, силу интонации и число шагов синтеза. При фиксированном seed одна и та же фраза всегда даёт один и тот же голос
- Синтез работает только на CPU сервера (ONNX Runtime; ни GPU, ни внешние API не используются)
- Числа модель не читает, поэтому их нужно писать словами — например, «dvadeset pet (25)»
Что я сделал
1. Подготовил сценарии: локальная Gemma 4 31B писала реплики для повседневных диалогов на хорватском. Я случайным образом задавал ситуацию, собеседника, эмоцию и длину — например, «разговаривает с бабушкой на рынке» или «испугалась странного звука ночью» — по 22 строки за раз. По задумке говорит одна женщина примерно 30 лет. Были смешаны 23 типа эмоций: нейтральная, радость, злость, шёпот и другие.
2. Сгенерировал речь: HiggsAudio v3 начитывала сценарии голосом из референсной записи длительностью 16 секунд. С тегами эмоций (<|emotion:anger|> и т. п.) она действительно злилась и радовалась. За примерно 5 часов было создано 4 500 файлов.
3. Проверил автоматически: Whisper large-v3 расшифровывала аудио, а я сравнивал текст со сценарием и отбрасывал ошибки чтения. Дополнительно модель распознавания говорящего измеряла сходство голоса с референсной записью, чтобы исключить клипы с изменившимся голосом. Прошли проверку 4 393 из 4 500 файлов (97,6%). После обрезки тишины в начале и конце получилось 7,46 часа.
4. Обучил маленькую модель: Matcha-TTS — TTS на основе flow matching — обучалась на RTX 4090 пять часов: около 30 тысяч шагов. Для преобразования обратно в звуковую волну, то есть вокодер, я использовал готовый публичный Vocos.
Хорватский почти всегда читается так, как пишется, поэтому я подавал на вход исходные буквы, не преобразуя их в фонетические символы. Однако lj, nj и dž — это по одному звуку, поэтому я объединял их как один символ.
Сравнение звука в процессе обучения
Я синтезировал фразу, отсутствующую в обучающих данных: «Molim Vas, možete li mi reći koliko košta ova haljina?» («Извините, сколько стоит это платье?»), используя модели на разных этапах обучения.
шаг 5 000 (примерно 50 минут с начала обучения)
шаг 10 000 (примерно 1 час 40 минут)
шаг 15 000 (примерно 2 часа 20 минут)
шаг 20 000 (примерно 3 часа 10 минут)
шаг 30 000 (примерно 5 часов, финальная версия)
Для сравнения — один обучающий пример, сгенерированный HiggsAudio в роли учителя: другая фраза — «Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.»
При расшифровке Whisper эта фраза на всех этапах — от шага 5 000 до финального — совпадала со сценарием слово в слово. То есть с самого начала модель умела произнести нужные слова.
Разница — в чистоте звука. На слух на шаге 5 000 слышен зернистый шум, а к шагу 10 000 он заметно уменьшается. Это хорошо видно на спектрограммах одного и того же аудио: по горизонтали время, по вертикали частота.
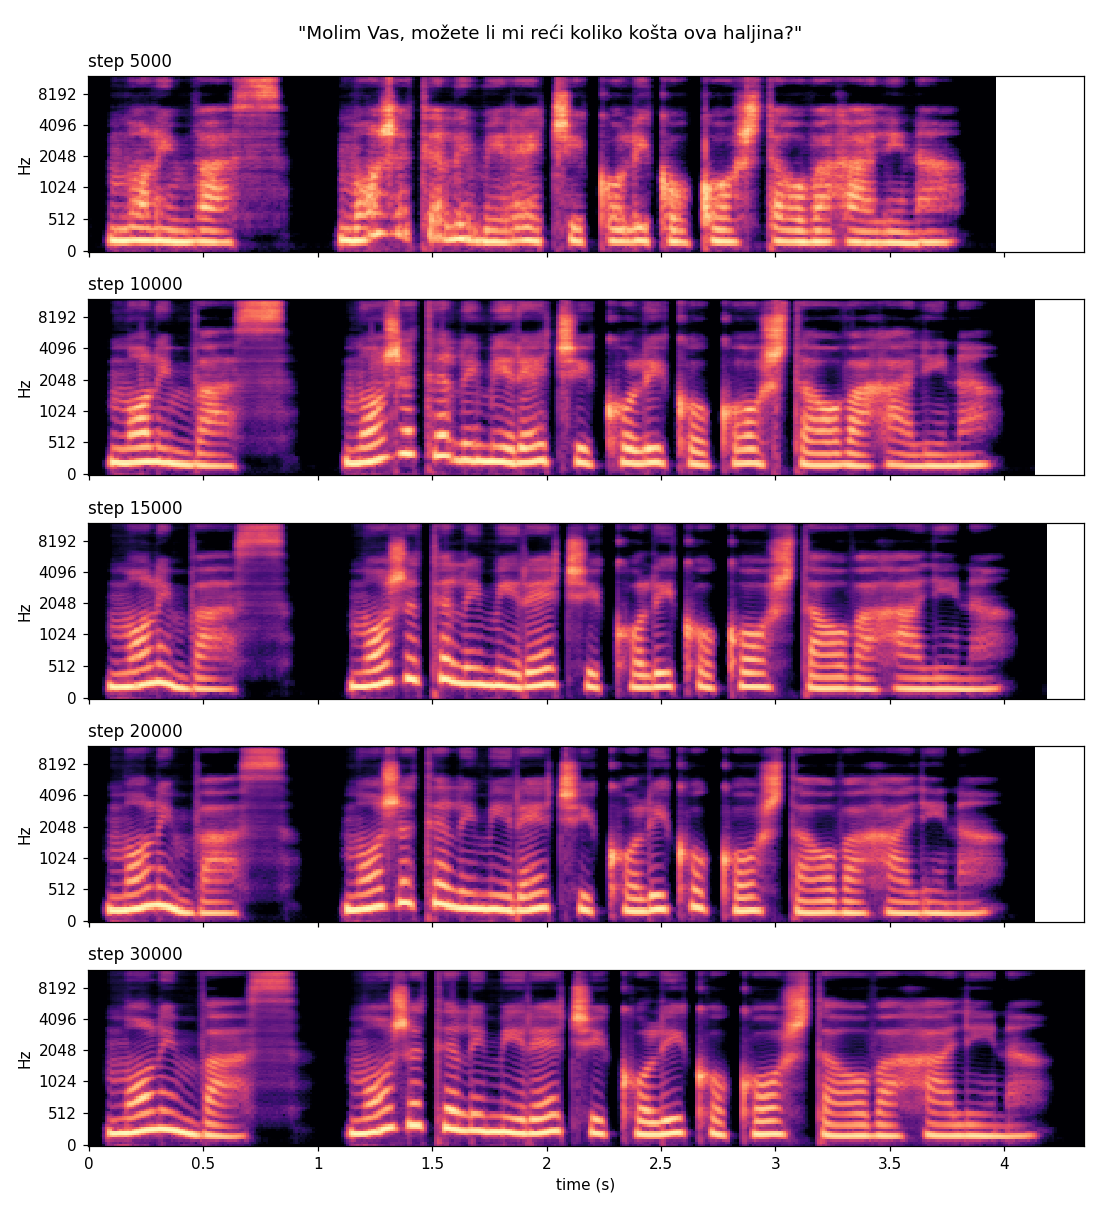
Горизонтальные полосы, соответствующие высоте голоса, то есть гармоники, на шаге 5 000 размыты, а промежутки между ними словно затянуты дымкой. Именно это слышится как шум. Начиная с шага 10 000 полосы становятся чёткими, а промежутки — тёмными. По мере обучения полосы плавнее изгибаются вверх и вниз, и, похоже, становится отчётливее изменение высоты голоса — интонация.
В цифрах
Я расшифровал Whisper large-v3 14 оценочных фраз, все вне обучающих данных, и измерил частоту символьных ошибок (CER). В набор вошли как короткие приветствия, так и монологи примерно по 16 секунд.
| Шаги | Время обучения | Частота символьных ошибок | Полное совпадение |
|---|---|---|---|
| 5 000 | около 50 минут | 1,1% | 9 / 14 |
| 10 000 | около 1 часа 40 минут | 3,4% | 8 / 14 |
| 15 000 | около 2 часов 20 минут | 0,7% | 11 / 14 |
| 20 000 | около 3 часов 10 минут | 0,9% | 11 / 14 |
| 30 000 | около 5 часов | 0,9% | 10 / 14 |
- Показатель ухудшился на шаге 10 000 почти исключительно из-за одной фразы «Bok! (Привет!)», которую распознали как «Vok». Разница в один символ из трёх означает для этой одной фразы ошибку 33%. На слух версия с 10 000 шагов была гораздо чище версии с 5 000. Частота символьных ошибок измеряет только то, правильно ли текст прочитан, поэтому чистоту звучания приходится оценивать на слух
- До конца оставалась ошибка в đ и dž в фразе «Đak je pojeo džem» («Ученик съел джем»). Эти звуки редко встречаются даже в хорватском, и распознавание выдавало «Žak» или «Džak»
Скорость на CPU
Я измерил скорость на i7-13700K в обычном PyTorch, без оптимизаций. Это средний результат трёх генераций четырёх фраз общей длительностью 47,6 секунды. RTF — это «время генерации ÷ длительность аудио»: чем меньше, тем быстрее.
| Число потоков | Число шагов | Matcha | Vocos | Общий RTF |
|---|---|---|---|---|
| 1 | 2 | 0.042 | 0.025 | 0.067 |
| 1 | 4 | 0.067 | 0.025 | 0.092 |
| 4 | 4 | 0.032 | 0.010 | 0.042 |
| 8 | 4 | 0.028 | 0.007 | 0.036 |
«Число шагов» — это количество итераций, в которых при синтезе из шума создаётся звук; в примерах выше использовалось 4. Даже на одном потоке 1 секунду аудио можно создать за 0,09 секунды. CPU смартфона медленнее, но, вероятно, сможет работать в реальном времени — это пока только предположение, поскольку на реальном устройстве я ещё не измерял.
Сколько часов данных нужно для TTS?
Раз за 7,5 часа удалось добиться такого результата, я изучил обычные ориентиры.
- Англоязычный LJSpeech, часто используемый для TTS одного голоса, содержит около 24 часов данных. На нём же обучена официальная модель Matcha-TTS
- Японский JSUT и китайский CSMSC содержат около 10 часов и обычно используются как корпуса одного голоса
- При обучении с нуля нижний предел — примерно 1 час, хотя в зависимости от модели может стать больше ошибок произношения
- При дообучении готовой модели есть сообщение, что 30 минут данных дали примерно такой же результат, как 27 часов обучения с нуля
Нашлась и работа об обучении Matcha-TTS исключительно на синтетической речи Шанхайского университета Цзяо Тун, опубликованная в декабре 2025 года. В ней говорится, что качество выше при большем разнообразии текстов, чистом аудио без шума и единообразной манере речи. В синтетических данных нет шумов и стиль речи стабилен, поэтому при одинаковой длительности они, возможно, обучаются легче, чем реальные записи. Вероятно, этим и объясняется результат на 7,5 часа в данном случае.
С чем пришлось повозиться
- Компьютер завис: две 31B-модели для создания сценариев случайно одновременно загрузились в GPU и переполнили VRAM. С тех пор правило такое: «на GPU всегда загружается только одна модель»
- Gemma 4 слишком много думала: около двух третей вывода занимали «размышления». После их отключения работа ускорилась примерно втрое
- Галлюцинация HiggsAudio: в первом тесте после фразы модель самовольно продолжила тишину словами «Hvala što pratite kanal» («Спасибо, что смотрите канал»), и получился клип на 81 секунду. Похоже, она запомнила заключительную фразу из YouTube. Я начал отбрасывать файлы, чья длина сильно отличается от ожидаемой
- Matcha-TTS не работал в Windows: некоторые расширения C не удавалось собрать, поэтому я переписал эту часть на Python (numba)