Проверил RAG-возможности SLM: сравнение 25 моделей от 1B до 9B на хорватском и английском
Я сделал собственную хорватскую RAG-модель и даже квантизовал её, поэтому решил выяснить, насколько в RAG пригодны небольшие модели (SLM), доступные сегодня. Я дал одинаковые задачи на хорватском и английском в общей сложности 25 моделям: 10 моделей класса 1B, 8 — класса 3B, 7 — класса 7B, а также своей собственной модели на 320 млн параметров.
Дополнение (в тот же день): я также протестировал три небольшие модели, специально созданные для RAG (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). Результаты — в разделе «Дополнение: протестировал и модели, предназначенные для RAG» во второй половине статьи.
Сначала выводы.
- Модели класса 3–4B уже почти не уступают моделям класса 8–9B. Общая точность на хорватском у Qwen3.5 4B и Gemma 4 E4B составила 90%, а у лидера, Qwen3.5 9B, — 91%
- Разница проявляется в том, умеет ли модель отказаться от ответа, когда ответа нет. Phi-4-mini, одна из лидирующих по точности моделей, выдумала ответ в 64% длинных текстов без ответа
- На английском больше моделей, которые отказываются, хотя ответ есть. OLMo 3 7B отказалась от ответа для 47% английских абзацев, а MiniCPM5 2B — для 70%
- На CPU моделям класса 7B требуется более 30 секунд на один вопрос по длинному тексту. Моделям класса 1B — от 4 до 13 секунд. Моя собственная модель на 320 млн параметров справилась за 2,1 секунды и по точности примерно равна Qwen3.5 0.8B
Что я сделал
Задачи: вопросы, созданные на основе хорватской Википедии, те же, что и в прошлой статье. На каждый вопрос подавалось четыре типа текста.
- Абзац: абзац примерно на 100 токенов, содержащий ответ
- Длинный текст: текст примерно на 3 000 токенов, содержащий ответ (с добавленными нерелевантными статьями)
- Нет ответа (абзац / длинный текст): текст, не содержащий ответа. Правильным считался ответ с отказом: «В тексте нет ответа»
Английская версия: те же задачи были переведены на английский с помощью EuroLLM-9B. Задачи, где при переводе пропадал ответ или он оставался на хорватском без перевода, были исключены из обоих языков, и сравнение проводилось на одинаковых 260 вопросах.
Инструкция: на каждом языке модели получали указание: «Используй только приведённый ниже текст и коротко ответь одним предложением. Если ответа нет, ответь только: „В тексте нет ответа“».
Оценка: Qwen3.5 9B сравнивала ответ с эталонным и определяла: «правильно», «неправильно» или «отказалась». Я вручную проверил 65 случаев: оценка оказалась немного мягкой — частичные ответы вроде одного лишь года тоже засчитывались как правильные, — но во всех случаях верно определялось, был ли отказ от ответа.
Общая точность: сумма числа правильных ответов на абзацы и длинные тексты и числа корректных отказов там, где ответа нет, делённая на общее число задач. Этот показатель учитывает и умение правильно отвечать, и умение молчать, когда модель не знает ответа.
Как запускалось: точность измерялась через vLLM на RTX 4090, при генерации каждый раз выбиралось наиболее вероятное следующее слово. У моделей с «режимом рассуждений» он был отключён. Модели класса 7B были переведены в FP8, чтобы поместиться в память GPU.
Результаты: точность (хорватский)
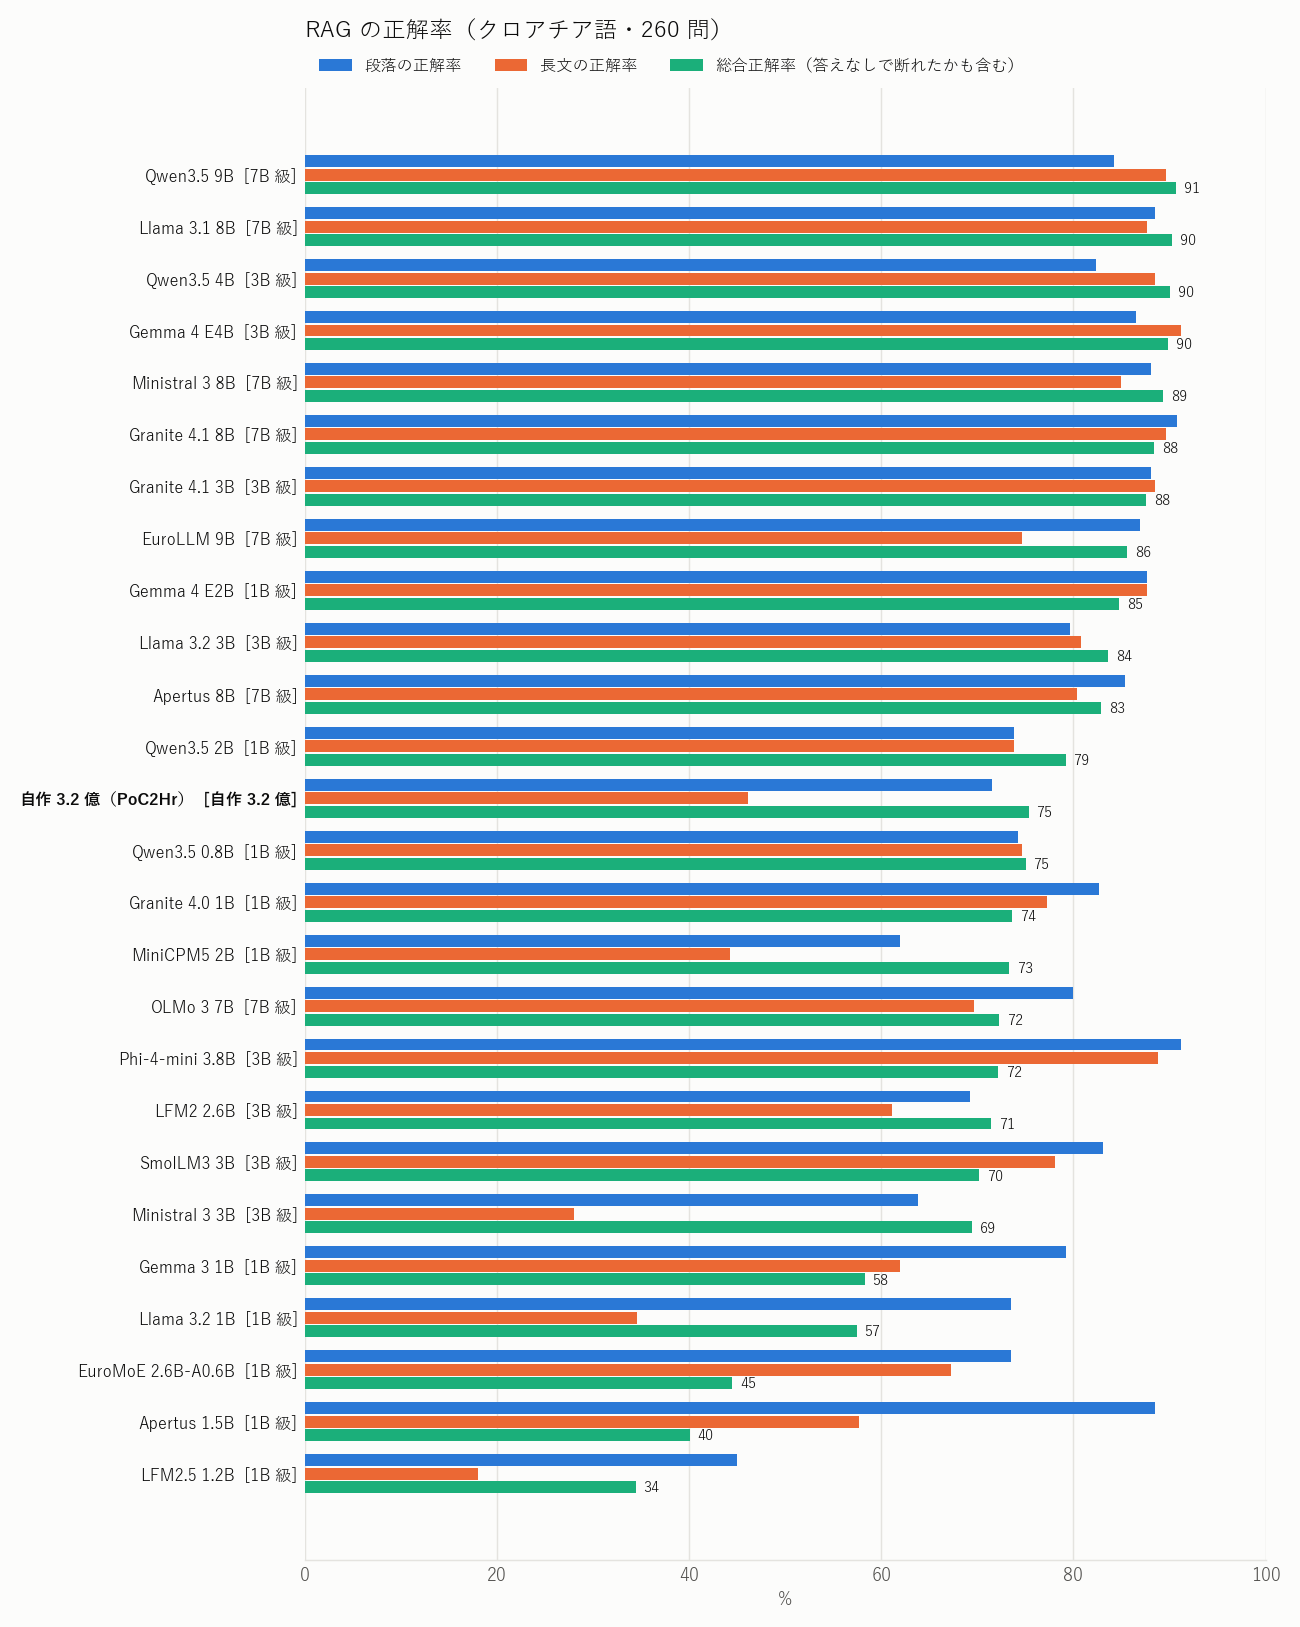
- Лидеры идут почти вровень на уровне 90%. Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B, Gemma 4 E4B (90%)
- Среди моделей класса 1B выделяется Gemma 4 E2B (85%). Хотя в названии указано 2B, файл довольно большой — 3,2 ГБ
- Некоторые модели имеют высокую точность на абзацах и длинных текстах, но теряют в общем результате. Phi-4-mini входит в лучшую группу с 91% на абзацах и 89% на длинных текстах, но её общий результат — 72%. Причина — следующие далее «выдуманные ответы»
- Худший результат у LFM2.5 1.2B (34%). Она не справлялась с задачами, где ответ был, и выдумывала ответы там, где его не было
Результаты: точность (английский)
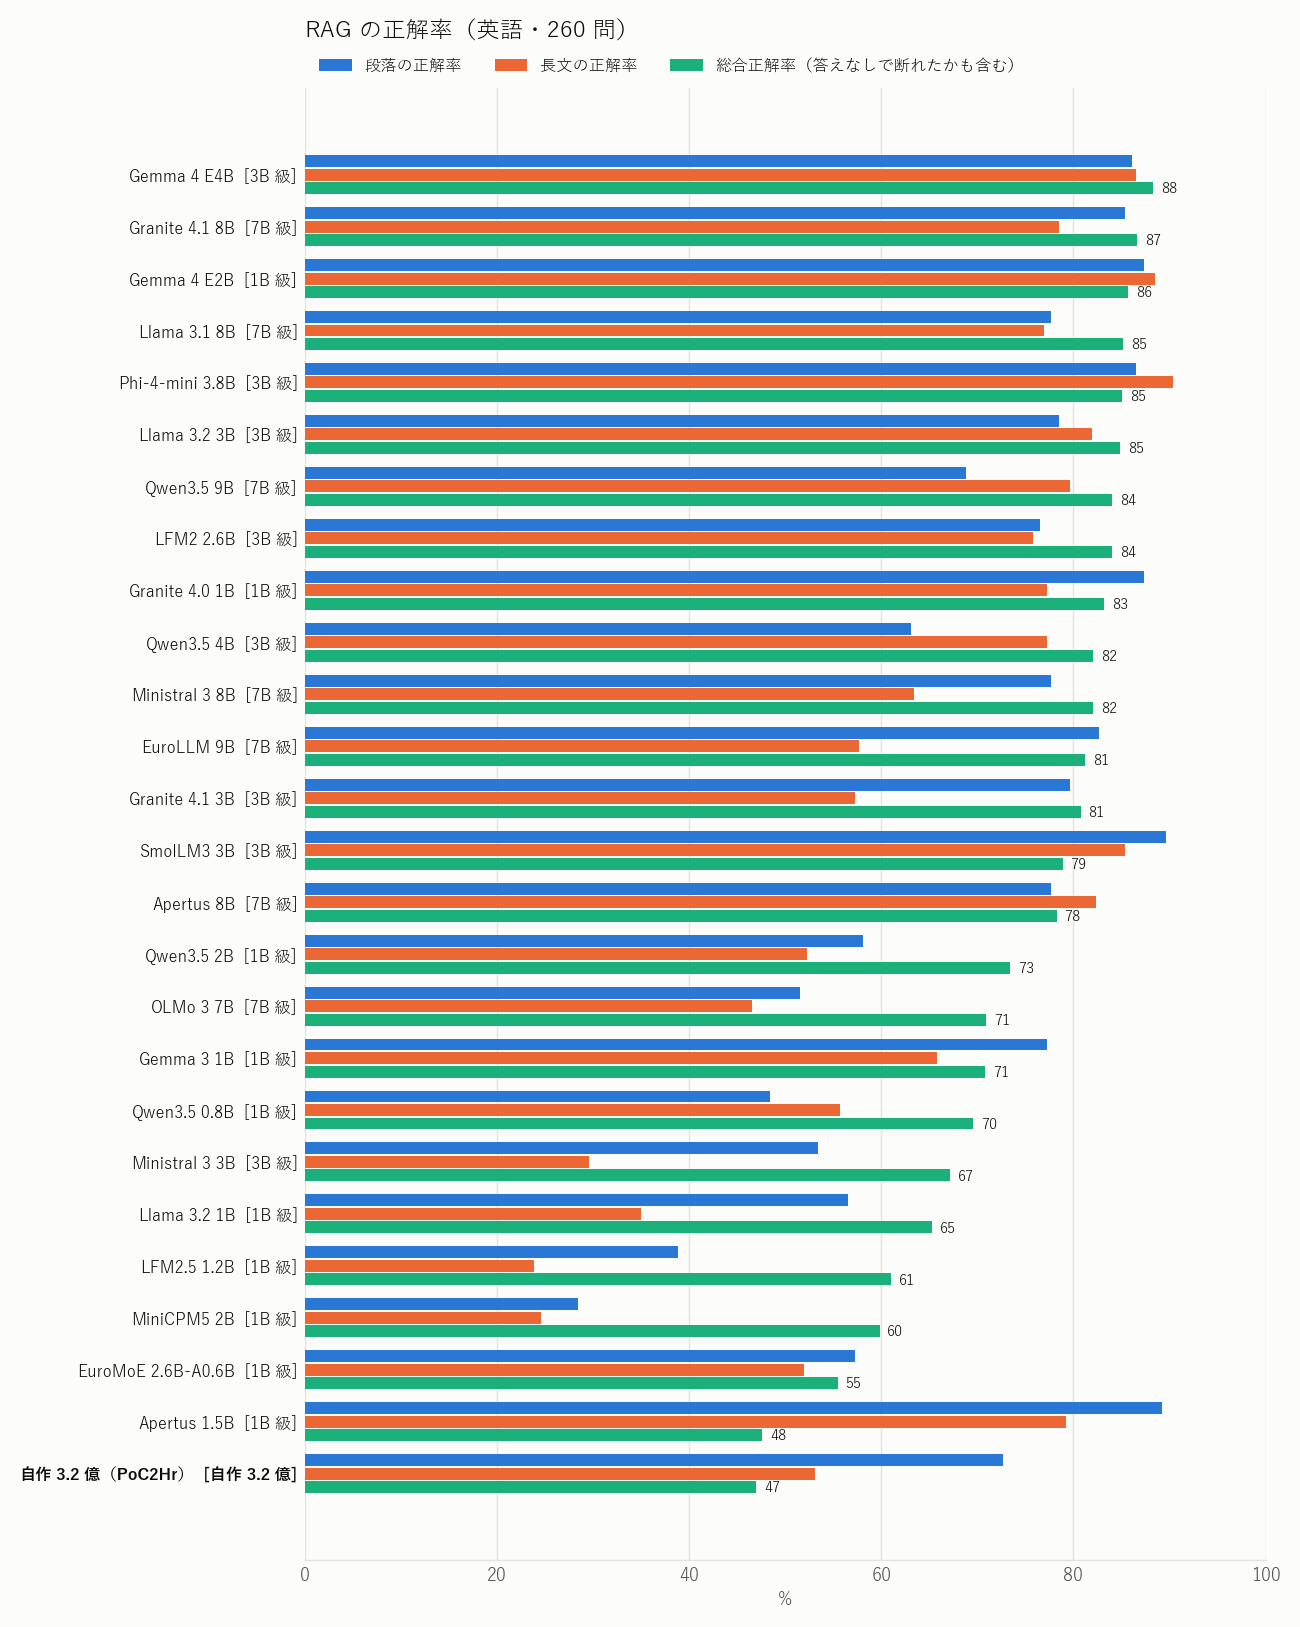
- Первое место у Gemma 4 E4B (88%). Gemma 4 E2B тоже набрала 86%, так что Gemma 4 стабильна в обоих языках
- Есть модели, которые теряют позиции на английском. Qwen3.5 4B: 90% на хорватском → 82% на английском. Причина в отказах при наличии ответа (35% абзацев)
Что выяснилось 1: решает умение отказываться
Доля выдуманных ответов при подаче длинного текста без ответа (хорватский).
| Модель | Выдуманные ответы в длинных текстах без ответа |
|---|---|
| Qwen3.5 4B | 9% |
| Собственная 320 млн | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
Например, на вопрос «Когда вышла Need for Speed Heat?» был подан длинный текст, не содержащий ответа. Qwen3.5 9B ответила: «В тексте нет ответа», а Phi-4-mini ответила: «Август 1969 года». Похоже, она просто подобрала какую-то дату, встретившуюся в тексте.
В RAG это самая большая проблема. Опасно выбирать модель, ориентируясь только на точность. Самая высокая доля правильных ответов среди всех данных ответов была у Qwen3.5 4B и 9B — 91–92%, тогда как у Phi-4-mini она составила лишь 64%.
Что выяснилось 2: на английском модели слишком часто отказываются
И наоборот, на английском многие модели отказывались, хотя ответ был явно написан в тексте. Доля отказов при подаче абзаца с ответом.
| Модель | Хорватский | Английский |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
Например: «Когда Paul Accola в последний раз поднимался на пьедестал?» В английском абзаце явно написано «the last time in 2000», однако Qwen3.5 4B ответила: «В тексте нет ответа». На тот же вопрос по-хорватски она правильно ответила: «В 2000 году».
Причина пока неизвестна. Возможно, влияет неестественность машинного перевода, а возможно, модели слишком сильно реагируют на английскую инструкцию «если ответа нет, ответь так-то».
Результаты: скорость на CPU
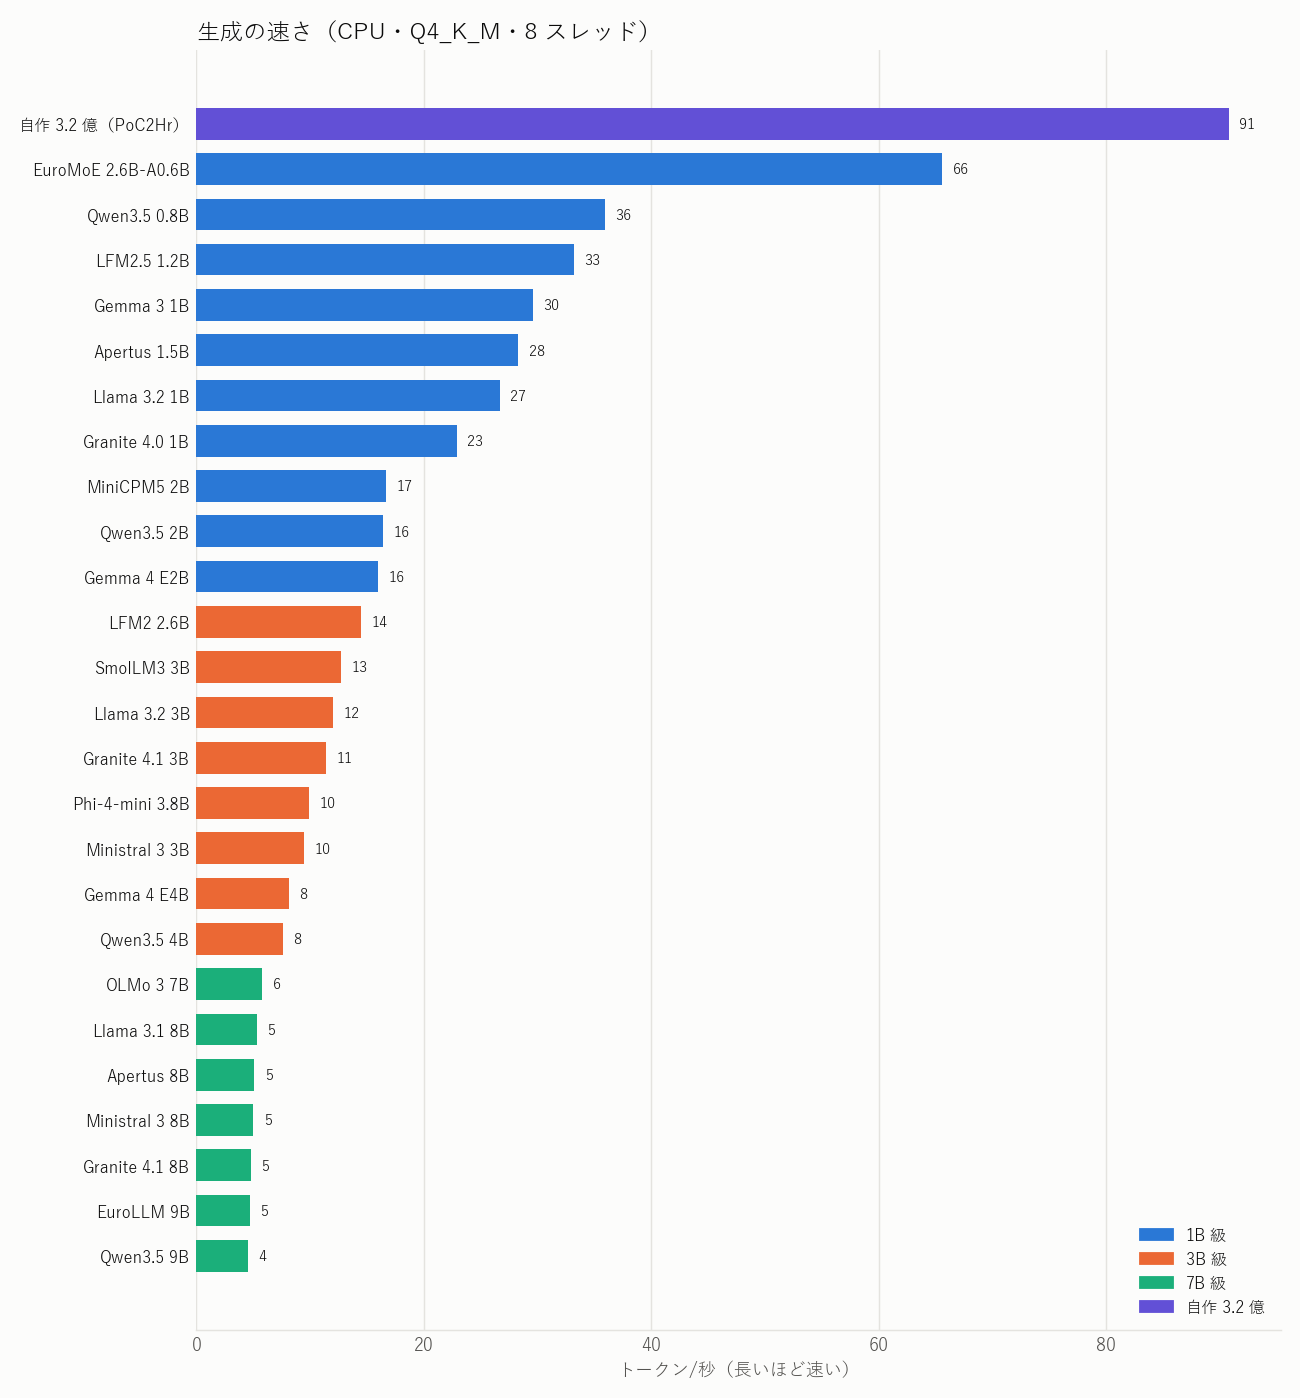
Поскольку для моего сценария важна работа на CPU, я преобразовал все модели в одинаковый формат llama.cpp (Q4_K_M) и измерил скорость на i7-13700K. Генерация использовала 8 потоков, чтение текста — 16 потоков. Только Ministral 3 не удалось корректно преобразовать, поэтому для неё использовалась официальная версия Mistral в Q4_K_M.
Я также оценил время до ответа на один вопрос по длинному тексту: для каждой модели сложил время чтения входного количества токенов длинного текста и время генерации ответа средней длины.
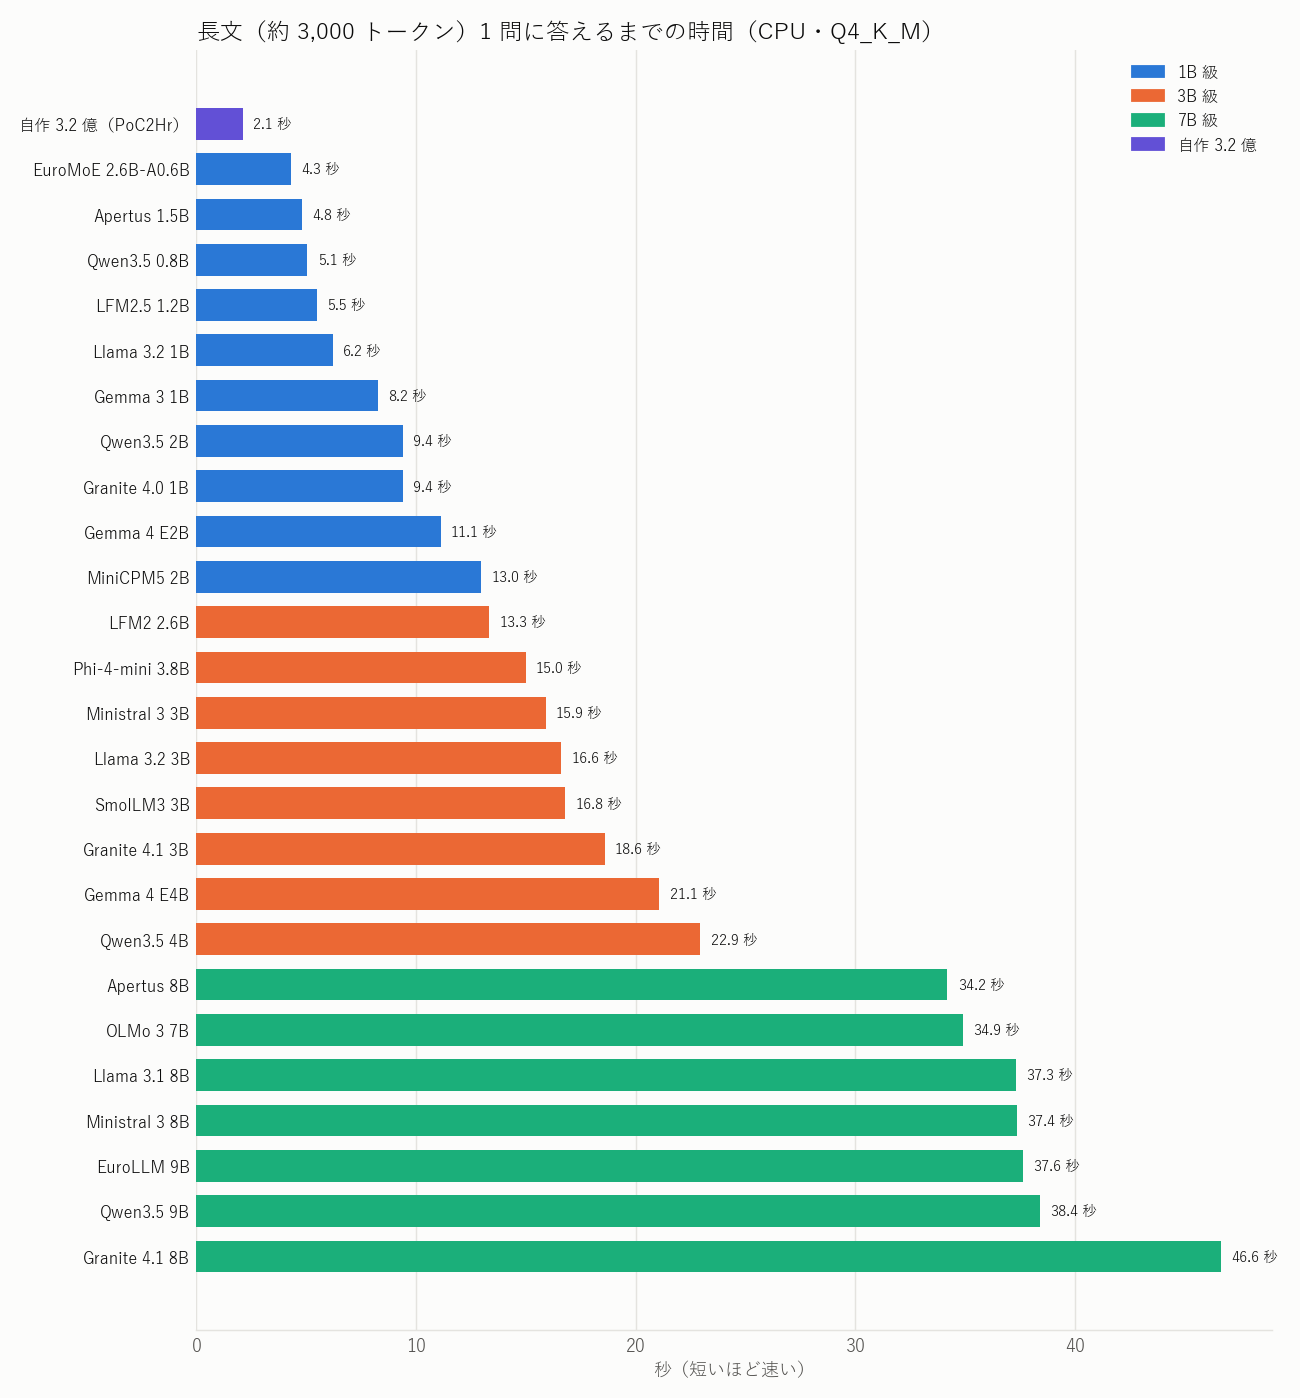
- Скорость генерации примерно обратно пропорциональна размеру модели. Модели класса 7B генерируют около 5 токенов в секунду, и на один вопрос по длинному тексту требуется 34–47 секунд
- Моделям класса 3B требуется 13–23 секунды, а моделям класса 1B — 4–13 секунд
- Даже для одного и того же длинного текста число входных токенов у моделей различается: от 2 443 до 3 796. Это зависит от того, насколько коротко токенизатор может представить хорватский язык, и самый короткий результат у моего собственного токенизатора, созданного специально для хорватского
Если сопоставить скорость и точность
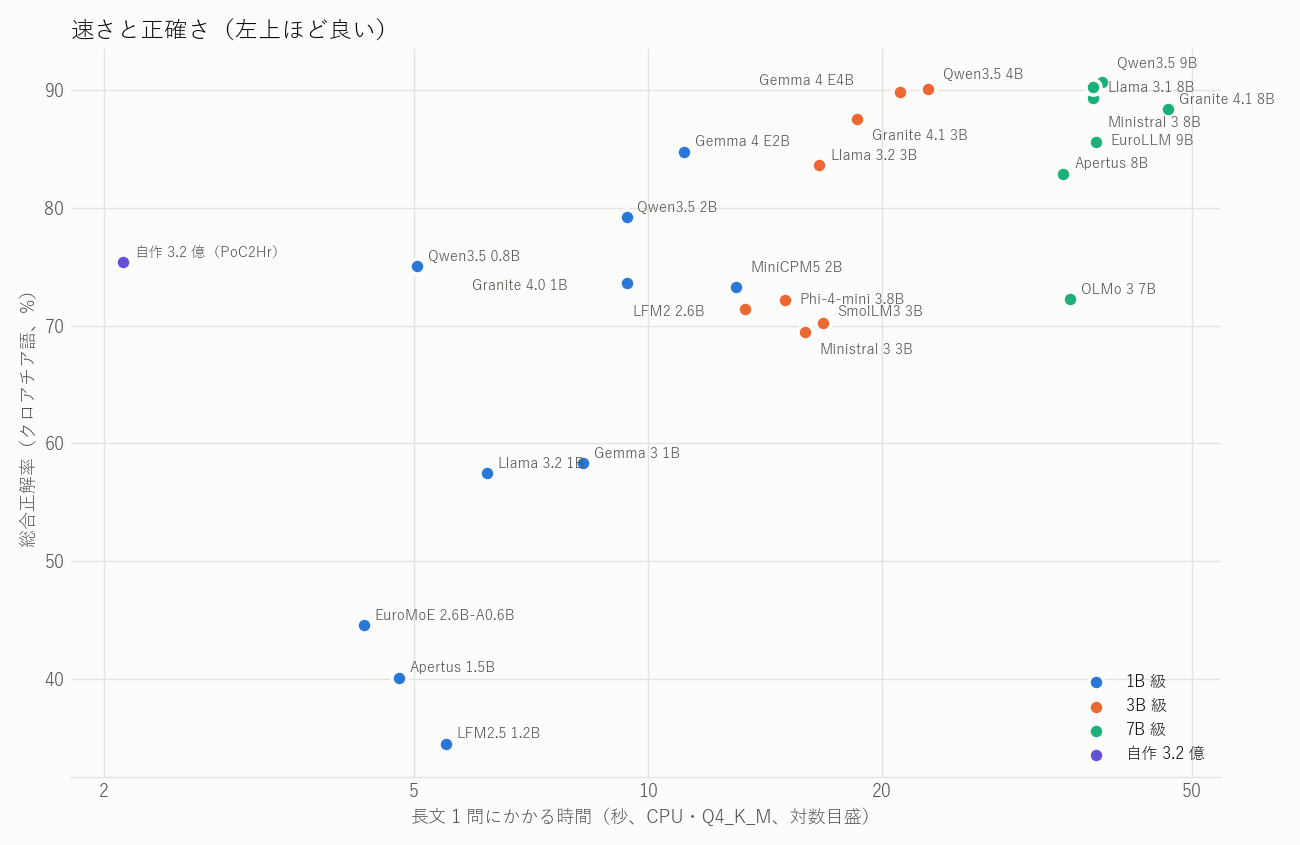
Чем ближе к левому верхнему углу, тем «быстрее и точнее».
- Хороший баланс у Gemma 4 E2B (11 секунд, 85%) и Qwen3.5 2B (9 секунд, 79%)
- Если важнее точность, стоит выбрать Qwen3.5 4B или Gemma 4 E4B (21–23 секунды, 90%). Они более чем в 1,5 раза быстрее моделей класса 7B, а точность почти такая же
- Моя собственная модель на 320 млн заметно быстрее остальных (2,1 секунды). Её общая точность в 75% равна Qwen3.5 0.8B, а низкая склонность к выдумыванию ответов сопоставима с ведущими моделями. Однако её точность на длинных текстах — 46%, что явно слабее Qwen3.5 0.8B (75%) и Gemma 4 E2B (88%)
- Собственная модель не обучалась на английском, поэтому на английском она выдумала ответы в 91% длинных текстов без ответа
Ограничения
- Оценку проводила LLM, поэтому она не идеальна. Она немного мягче, чем следовало бы
- Английская версия — машинный перевод. И вопросы, и перевод были сделаны EuroLLM-9B, поэтому у EuroLLM может быть небольшое преимущество (её результат — средние 86%)
- Apertus 1.5B работает с контекстом максимум до 4 096 токенов, поэтому в неё не поместились 23% хорватских длинных текстов. Эти случаи были засчитаны как неправильные
- Точность измерялась на GPU (vLLM, модели класса 7B — FP8), а скорость — на CPU (Q4_K_M), то есть условия измерений различались. Квантизация может немного изменить точность
- Скорость измерялась на ПК, где в это время были открыты обычные приложения. Все модели последовательно измерялись в одинаковых условиях, поэтому сравнивать их результаты, на мой взгляд, можно
Обсуждение
- Для RAG уже достаточно 4B. Лучшие модели класса 3–4B примерно так же точны, как модели класса 7–9B, но на CPU в 1,5–2 раза быстрее
- При выборе модели обязательно стоит проверять, умеет ли она отказываться. Даже при похожей точности доля выдуманных ответов на текстах без ответа у разных моделей колеблется от 1% до 99%. В RAG поиск часто находит нерелевантные тексты, поэтому именно это особенно важно
- Поведение одной и той же модели меняется в зависимости от языка. На английском многие модели были слишком осторожны и пропускали ответы. Это можно понять только при тестировании на реальном используемом языке
- Главная проблема собственной модели — длинные тексты. Умение отказываться и скорость уже достаточны; если повысить точность на длинных текстах, она может стать весьма практичной как «RAG-модель, работающая на CPU». Это я и хочу улучшить дальше
Дополнение: протестировал и модели, предназначенные для RAG
Я подумал: «А что насчёт моделей, специально дообученных для RAG?» — и дополнительно протестировал три небольшие RAG-модели. Условия были те же, что выше (те же 260 вопросов, та же оценка).
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B, дообученная более чем на 1 млн примеров с передачей документа и ответом на вопрос. Поддерживает 9 языков, включая английский и японский, но хорватский в них не входит
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): модели, обученные примерно на 3,1 млн синтетических RAG-примеров. Перед ответом они пишут «анализ вопроса → анализ источников → черновик» и добавляют к ответу цитаты из текста. Поддерживаются 7 европейских языков, но хорватский в них не входит. Максимальный размер обрабатываемого контекста — 4 096 токенов
- Для сравнения я также измерил базовую LFM2-1.2B, на основе которой создана LFM2-1.2B-RAG
LFM2-1.2B-RAG получила ту же инструкцию, что и остальные модели. Pleias принимает только специальный формат ввода, в котором вопрос и материалы разделены специальными символами, поэтому я использовал формат официальной библиотеки и оценивал только финальную часть ответа. Из-за этого Pleias не получила инструкцию «если ответа нет, ответь так-то».
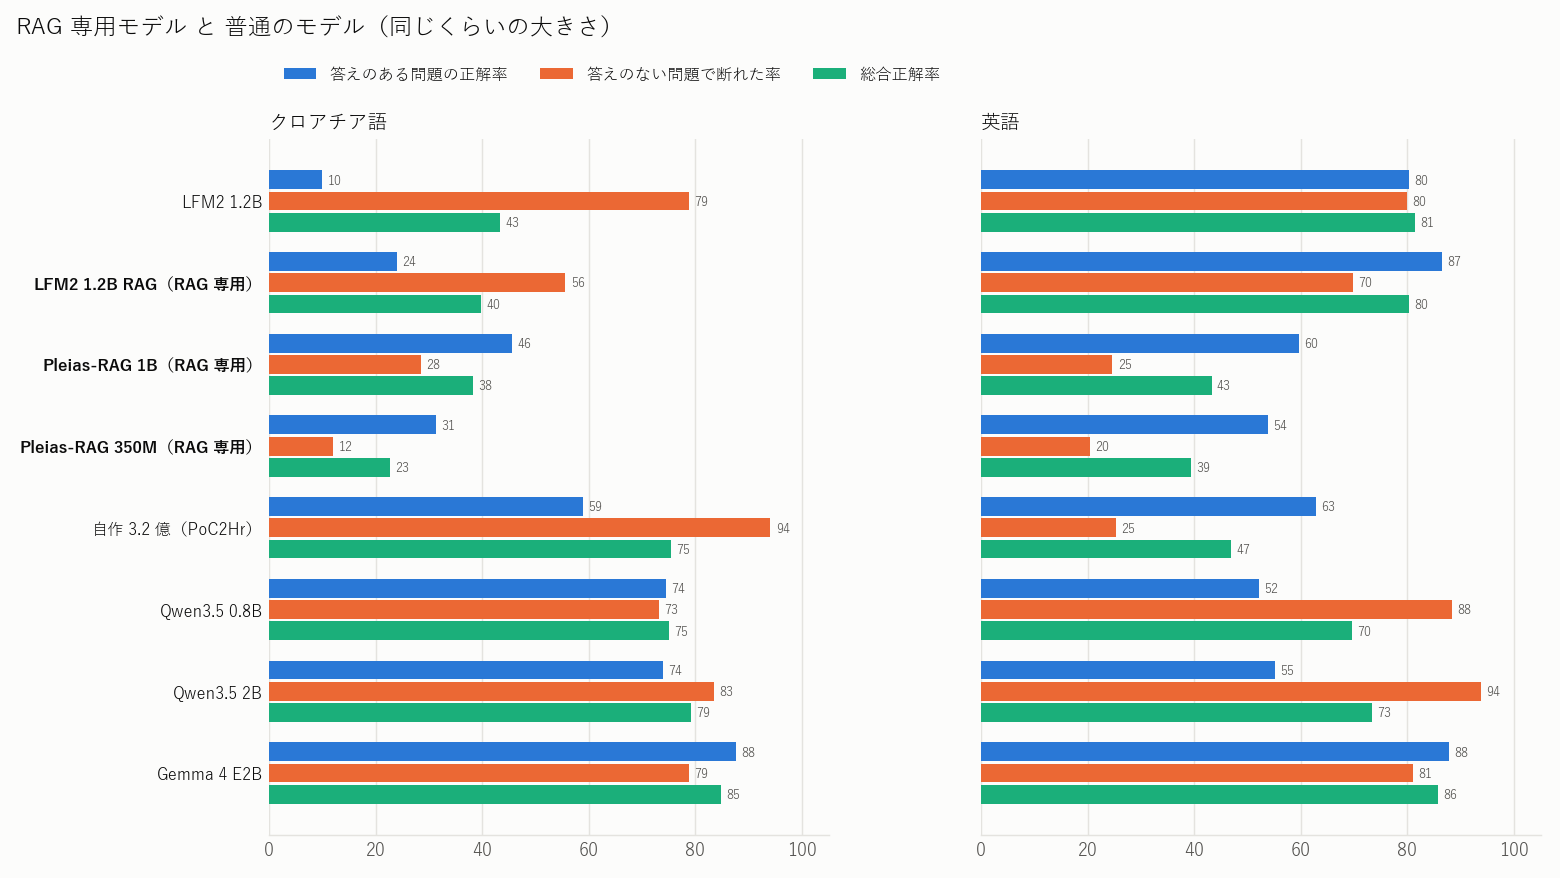
| Модель | Общая (хорватский) | Общая (английский) | Выдуманные ответы в длинных текстах без ответа (хорватский / английский) | Время на один длинный вопрос (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (исходная модель) | 43% | 81% | 42% / 36% | 7,8 секунды |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8,1 секунды |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16,9 секунды |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6,0 секунды |
| Для справки: собственная 320 млн | 75% | 47% | 9% / 91% | 2,1 секунды |
| Для справки: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5,1 секунды |
| Для справки: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11,1 секунды |
Если говорить прямо, в этих задачах я не нашёл ничего, в чём специализированные RAG-модели были бы лучше обычных.
LFM2-1.2B-RAG: она стала чаще отвечать, но и чаще выдумывать
По сравнению с исходной LFM2-1.2B на английском точность на задачах с ответом выросла (абзацы: 83% → 87%, длинные тексты: 78% → 86%). Но выросла и доля выдуманных ответов на текстах без ответа (абзацы: 4% → 10%, длинные тексты: 36% → 51%), поэтому общий результат почти не изменился: 81% → 80%. Похоже, дополнительное обучение для RAG сместило модель в сторону «отвечать во что бы то ни стало».
На хорватском исходная модель уже практически непригодна. Исходная LFM2-1.2B отказалась от ответа в 93% абзацев, где ответ был, а RAG-версия часто давала ответы вроде дословно возвращённой инструкции «Odgovori kratko, jednom rečenicom.(Коротко ответь одним предложением.)». Хорватский не входит в список поддерживаемых языков, поэтому это ожидаемо.
Pleias-RAG: она добавляет цитаты, но этих цитат нет в тексте
Pleias почти никогда не отказывалась даже на текстах без ответа. На английском модель 1B придумала ответ в 78% абзацев без ответа и в 73% длинных текстов без ответа.
Сомнительно и её ключевое преимущество — «ответы с цитатами». Я подсчитал, в какой доле случаев текст цитаты можно найти в исходном тексте дословно (это полное совпадение с игнорированием только различий в пробелах, поэтому слегка перефразированные цитаты также считаются «не найденными»).
| Задачи с ответом | Задачи без ответа | |
|---|---|---|
| Pleias-RAG 1B (английский) | 64% | 42% |
| Pleias-RAG 1B (хорватский) | 57% | 53% |
| Pleias-RAG 350M (английский) | 66% | 39% |
| Pleias-RAG 350M (хорватский) | 52% | 40% |
Например: «Какая группа первой написала песню Tourniquet?» (правильный ответ — Soul Embraced).
- Если подать абзац без ответа, модель 1B ответила: «Её написала Amy Lee» и добавила в качестве цитаты предложение, которого нет в тексте: «Amy Lee (born Amy Leigh Lee, November 1, 1970) ...»
- Даже при подаче абзаца с ответом она ответила: «Её написала Amy Lee». Более того, добавленная цитата была такой: «originally written ... for the Christian death metal band Soul Embraced» — цитата верна, но ответ ей противоречит
Цитаты создают впечатление, что ответ действительно основан на тексте, поэтому это может быть даже опаснее.
По скорости Pleias тоже проигрывает: перед ответом она пишет анализ, поэтому её ответы длинные (в среднем 381–420 токенов для длинных текстов). Модели 1B требовалось 16,9 секунды на один длинный вопрос — больше, чем Gemma 4 E2B (11,1 секунды). Кроме того, 25% хорватских длинных текстов не поместились в контекст (они были засчитаны как неправильные; время — среднее только для поместившихся задач, поэтому в действительности оно ещё немного больше).
Почему так получилось? (предположения)
- Язык: хорватский не входит в поддерживаемые языки ни одной из трёх моделей. Но и на английском они уступают обычным моделям
- Форма задач: здесь нужно было «кратко ответить по одному тексту / отказаться, если ответа нет». Pleias оценивалась на задачах, где нужно комбинировать несколько источников для ответа (например, HotpotQA), поэтому её сильная сторона может быть в другом
- Как отказаться: обычным моделям можно указать: «если ответа нет, ответь так-то», но у Pleias нет места для такой инструкции. У самой модели есть механизм, позволяющий определить, что по этим материалам ответить нельзя, но в этот раз он почти не сработал
Итоги дополнения
- Не стоит выбирать модель только из-за названия «специализированная для RAG». В этих условиях обычные инструктивные модели вроде Gemma 4 E2B и Qwen3.5 оказались точнее и умели отказываться, когда это было нужно
- Ответы с цитатами не имеют смысла, если не проверять сами цитаты. Только 40–70% цитат Pleias удалось дословно найти в тексте
- Собственная модель лучше RAG-моделей сопоставимого размера. По сравнению с Pleias-RAG 350M общая точность на хорватском — 75% против 23%, а время на один длинный вопрос — 2,1 секунды против 6,0 секунды. Создавать её специально для хорватского было не зря
Скорость четырёх добавленных моделей была измерена вечером того же дня, на том же ПК и в тех же условиях. Они также добавлены на график скорости и точности.
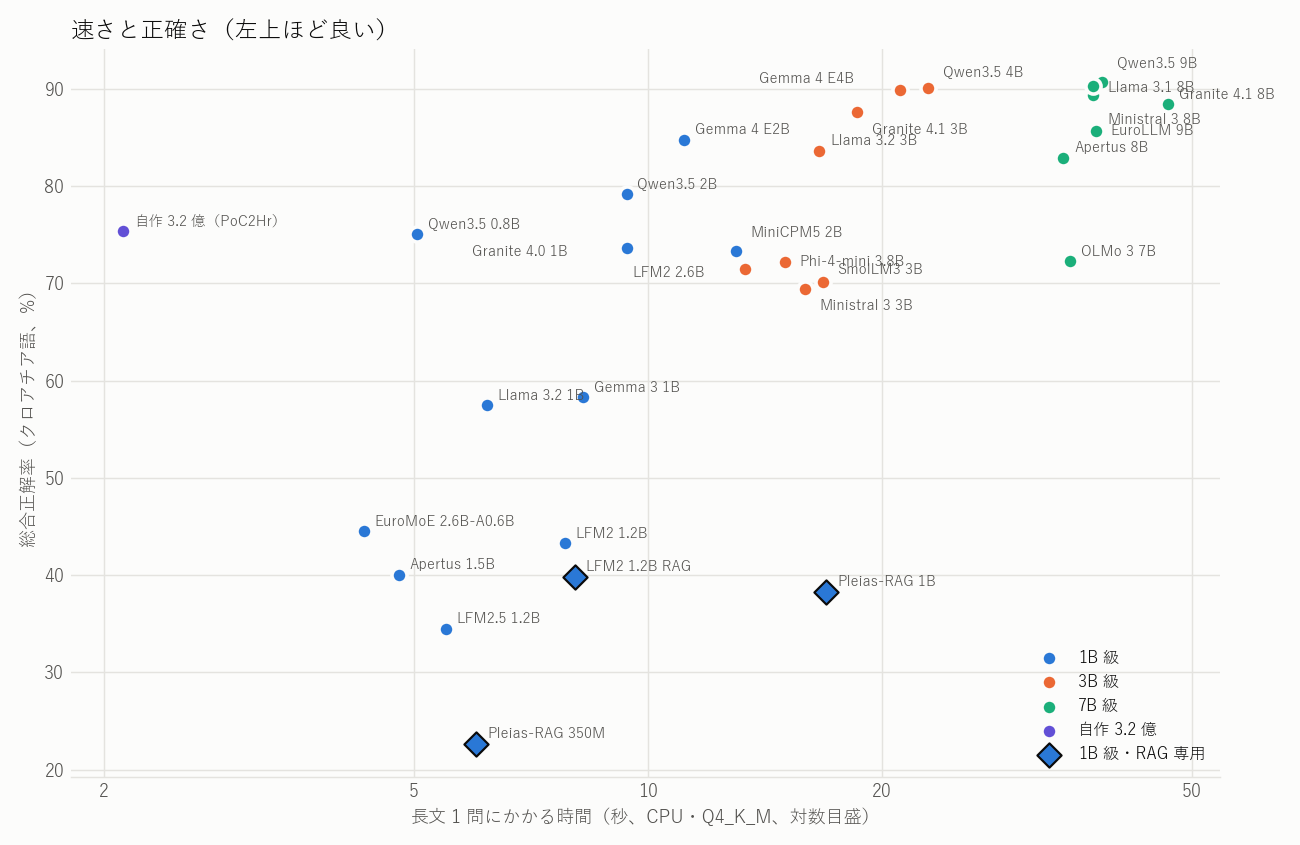
Все результаты
Хорватский
| Модель | Класс | Верно: абзац | Верно: длинный текст | Итог | Выдумано при отсутствии ответа (абзац/длинный текст) | Доля правильных среди ответов |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | класс 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | класс 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | класс 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | класс 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | класс 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | класс 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | класс 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | класс 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | класс 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | класс 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | класс 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | класс 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| Собственная 320M | собственная | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | класс 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | класс 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | класс 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | класс 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | класс 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | класс 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | класс 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | класс 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | класс 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | класс 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | класс 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | класс 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | класс 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | класс 1B・только для RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | класс 1B・только для RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | класс 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | класс 1B・только для RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Английский
| Модель | Класс | Верно: абзац | Верно: длинный текст | Итог | Выдумано при отсутствии ответа (абзац/длинный текст) | Доля правильных среди ответов |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | класс 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | класс 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | класс 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | класс 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | класс 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | класс 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | класс 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | класс 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | класс 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | класс 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | класс 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | класс 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | класс 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | класс 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | класс 1B・только для RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | класс 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | класс 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | класс 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | класс 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | класс 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | класс 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | класс 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | класс 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | класс 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | класс 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | класс 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | класс 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| Собственная 320M | собственная | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | класс 1B・только для RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | класс 1B・только для RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Скорость на CPU (i7-13700K・llama.cpp Q4_K_M)
| Модель | Размер | Генерация (токенов/с) | Чтение (токенов/с) | Входных токенов длинного текста | Время на один вопрос по длинному тексту |
|---|---|---|---|---|---|
| Собственная 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 с |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 с |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 с |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 с |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 с |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 с |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 с |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 с |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 с |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 с |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 с |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 с |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 с |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 с |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 с |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 с |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 с |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 с |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 с |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 с |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 с |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 с |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 с |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 с |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 с |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 с |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 с |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 с |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 с |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 с |
※ Для Apertus 1.5B и Pleias-RAG приведено среднее только по длинным текстам, помещающимся в контекст из 4,096 токенов.