Я обучил GPT-2 с нуля на одной RTX 4090: за день превзошёл оригинал и научил его общаться
Я попробовал обучить GPT-2 (124M) с нуля на одной домашней RTX 4090. Всё — от подготовки данных и предобучения до instruction tuning (SFT), чтобы модель могла общаться, — сделал на собственном ПК.
Если сразу перейти к выводам, получилось вот что.
- Предобучение завершилось примерно за 21 час. На тесте здравого смысла HellaSwag модель набрала 30,5% — выше, чем 29,4% у оригинальной GPT-2 124M
- SFT занял чуть меньше двух часов. Уже через 5 минут после начала обучения модель стала отвечать по-человечески, как в разговоре
- Но внутри она по-прежнему полна галлюцинаций: спокойно утверждает, что «население Парижа — 2,4 миллиарда» или что «12+7=30»
Было очень интересно наблюдать, как GPT-2 постепенно умнеет, поэтому я собрал весь процесс в этой статье.
Окружение
- GPU: RTX 4090 (24 ГБ)
- CPU: i7-13700K / 64 ГБ памяти
- ОС: Windows 11 (без WSL, прямо в Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
Код устроен так же, как в nanoGPT / build-nanogpt Карпати. Я попросил Claude Code: «Собери GPT-2 в рамках того, что можно сделать на GPU этого ПК за один день», — и он помогал со всем: от предложения структуры и создания скриптов до мониторинга обучения.
Подготовка данных: 10B токенов готовы за 12 минут
Для обучения я использовал версию FineWeb-Edu на 10B токенов — высококачественный англоязычный веб-текст образовательной тематики. В parquet это около 27 ГБ.
Сначала обычное скачивание через Hugging Face выдавало всего 1,7 МБ/с, так что на загрузку всего набора ушло бы больше четырёх часов. После установки hf_transfer скорость выросла до 60–70 МБ/с: файл на 2 ГБ скачивался за 30 секунд. Узким местом стала токенизация, но в итоге всё вместе — загрузка и токенизация — заняло около 12 минут.
Кстати, сначала я задал HF_HOME, чтобы изменить каталог кеша, после импорта huggingface_hub. Из-за этого настройка не сработала, и данные начали скачиваться на другой диск. Эта переменная окружения читается при импорте, поэтому задавайте её до import. Небольшая, но неприятная ловушка.
Настройки обучения
| Параметр | Значение |
|---|---|
| Модель | GPT-2 small (12 слоёв, 768 измерений, 124 млн параметров) |
| 1 шаг | около 520 тыс. токенов (16×1024, 32 шага накопления градиента) |
| Число шагов | 16 000 (около 8,4B токенов) |
| Скорость | около 120 тыс. токенов/с |
| VRAM | около 12 ГБ |
Часто говорят, что torch.compile не работает в Windows и нужно переходить на WSL, но в окружении с triton-windows он запустился напрямую.
На все 10B токенов потребовалось бы больше 24 часов, поэтому я сократил набор до 8,4B токенов, чтобы уложиться в один день.
Небольшой приём: размер словаря был увеличен с 50257 до 50304 — числа, кратного 128. Это известная техника Карпати, ускоряющая матричные вычисления на GPU. Позже она неожиданно пригодилась при превращении модели в чат-бота.
Инцидент: обучение остановилось через 2,5 часа
Я посмотрел промежуточные результаты и обнаружил, что обучение остановилось. Причиной стали данные для оценки HellaSwag. Код из семейства nanoGPT получает их из GitHub-репозитория rowanz/hellaswag, но там оказался ответ «451 Unavailable For Legal Reasons» — публикацию отключили по юридическим причинам. Оценка завершилась ошибкой 404 и вместе с ней упало всё обучение.
Я переключил загрузку на Rowan/hellaswag в Hugging Face — там те же 10 042 вопроса — и продолжил с чекпойнта, который сохранялся каждые 500 шагов. Также обернул оценку в try/except, чтобы ошибка оценки больше не останавливала обучение.
При долгом обучении нельзя допускать, чтобы оно падало из-за сбоев во «внешних» вещах — оценке, логировании и тому подобном. Это важно.
Результат: модель превзошла оригинальную GPT-2
Вот как менялся loss на валидационных данных. В первый час он резко снизился, а затем продолжал падать медленнее.
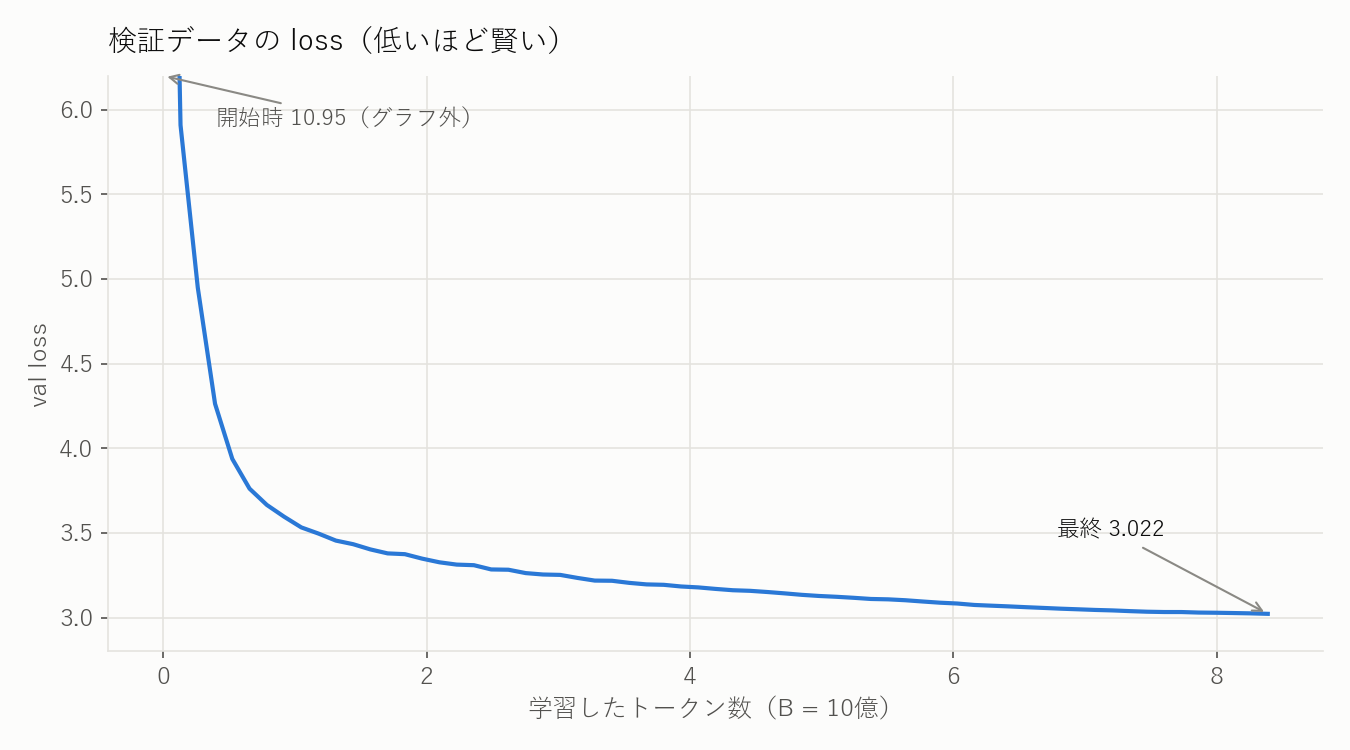
Стартовый loss 10,95 почти совпадает с ln(50304)≒10,83. То есть модель начинала в состоянии, когда совершенно наугад выбирала одно слово из 50 тысяч.
Точность на HellaSwag выглядела так.
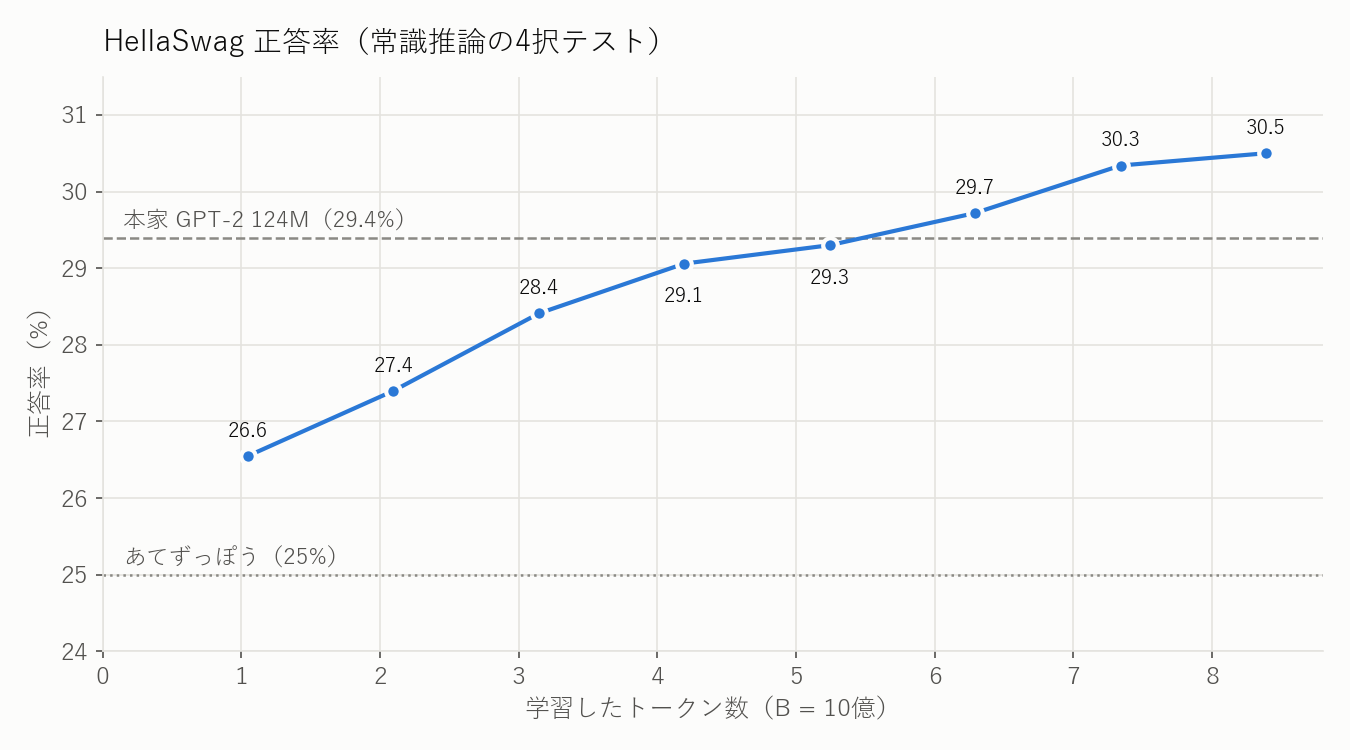
Примерно на 6,3B токенов (шаг 12 000) модель превысила 29,4% оригинальной GPT-2 124M, а в конце достигла 30,5%. Оригинальная GPT-2 обучалась на WebText. Здесь использовался FineWeb-Edu, и, вероятно, помогли более качественные данные образовательной тематики.
Как модель постепенно умнела
Во время обучения я каждый час генерировал текст с одним и тем же промптом и записывал результат. Это было самым интересным.
До обучения (случайное состояние)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
Слова просто стоят в совершенно случайном порядке.
Через 37 минут (0,26B токенов)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
Форма предложения уже есть. Модель понимает, что речь идёт о столице, но называет столицей Франции столицу Шотландии.
Примерно через 2 часа (0,79B токенов)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
Грамматика стала довольно естественной. Но взамен модель начала уверенно выдавать правдоподобную ложь, расставляя специализированные термины. Похоже на раннюю форму галлюцинаций.
Около 2,1B токенов
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
Наконец-то она сказала Paris! Но тут же добавила ложную статистику: «Франция производит примерно 50% мировой стали».
Я задал готовой базовой модели несколько вопросов
Я задал 10 вопросов в формате Question: ... Answer:.
- What is the capital of France? → начинает перечислять варианты от (a) до (i), словно составляет тест
- Who was Albert Einstein? → «Родился 16 ноября 1918 года в Сент-Луисе, штат Миссури. Его отец был шахтёром, а сам он работал школьным учителем». Всё ложь, но написано как биография
- What is 12 plus 7? → «12 plus 7 is an arithmetic expression.». Вместо вычисления начинает объяснять определение
У модели есть некоторые знания, но она не знает поведения «отвечать на вопрос». Базовая модель — это всего лишь машина, которая продолжает текст, так что это закономерно.
Я научил её общаться с помощью SFT
Дальше я провёл instruction tuning (SFT), чтобы модель могла отвечать на вопросы как ChatGPT.
- Данные:
smol-smoltalkиз Hugging Face (около 460 тыс. диалогов, 270 млн токенов) - Формат чата: добавлены разделители вроде
<|user|>,<|assistant|>и<|end|>. Здесь я использовал свободные номера, появившиеся, когда увеличил словарь до 50304. Специальные токены удалось добавить без изменения архитектуры модели, и приём, сделанный ради скорости, здесь оказался полезен - Обучается только часть с ответом: вопрос модель лишь читает, а копировать учится ответ ассистента и финальный
<|end|> - 2 эпохи, около 1 часа 50 минут
Важно обучать модель и на <|end|>. Благодаря этому она сама останавливается, когда закончила говорить. ChatGPT и подобные системы работают по тому же принципу: при появлении маркера окончания генерация прекращается.
Уже через 5 минут ответы стали похожи на разговор
До начала SFT (шаг 0) неизвестные разделители сбивали модель с толку, и она бесконечно повторяла «jakjakjakjak…». Но уже через 500 шагов — примерно 5 минут — ответы стали похожи на диалог.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
Причём она действительно заканчивает фразу и останавливается. Стиль общения усвоился почти мгновенно.
Но знания остались прежними. Промежуточная модель утверждала, что Париж — крупнейший город мира с населением около 2,4 миллиарда человек.
Сравнение до и после SFT
Я сравнил ответы на одни и те же вопросы до SFT — у базовой модели — и после него.
| Вопрос | До SFT | После SFT |
|---|---|---|
| What is the capital of France? | Начинает перечислять варианты (a)–(i) | «The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.» |
| Who are you? | «I am the person who has the gift for all that I do.» | «I'm a language learning AI assistant with over 10 years of experience» (у ИИ — 10 лет опыта) |
| Translate "Good morning" into French. | Начинает говорить о чём-то, не связанном с вопросом | «Bonjour!» (верно, но потом бесконечно повторяет «Good morning (modifier)») |
| What is 12 plus 7? | «Это arithmetic expression» | «12 + 7 = 21» → «12 + 7 = 30» → «35 + 7 = 34»: с правдоподобным видом ошибается всё сильнее |
| Who was Albert Einstein? | Школьный учитель, чей отец был шахтёром | В целом верно называет его «prominent physicist». Но «родился 24 февраля 1905 года в Вене» — ложь |
Манера речи и формат — полностью ассистентские. Но содержание часто ложно. С вычислениями всё было совсем плохо.
Я попробовал пообщаться с ней по-настоящему
Я сделал chat.py, позволяющий разговаривать с моделью в терминале, и попробовал задать вопросы.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Она следует инструкции «одним предложением». Базовая модель так не умела.
В другом диалоге я спросил о столице, а затем продолжил вопросом о населении.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Она понимает предыдущий контекст: «there» означает Японию. Но сразу после заявления о населении в 50 тысяч человек говорит, что в северной части страны живут 1,5 миллиарда. Полный хаос.
Когда я спросил по-японски «Какая столица Японии?», она ответила так:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Модель обучалась только на английских данных, поэтому японский, похоже, показался ей странным текстом, который нужно отредактировать.
Наконец, я попросил её написать хайку о GPU — и получил стихотворение, где она бесконечно повторяла «I see the world, the thoughts, the emotions». Вот тебе и хайку.
Что я понял в процессе
- На одной 4090 за день можно создать модель, превосходящую оригинальную GPT-2. Потребление GPU было около 430 Вт. Электричество только для GPU обошлось примерно в 300 иен — это оценка
- Манера общения усваивается мгновенно, но знания определяются предобучением. SFT за 5 минут придал модели разговорный формат, но почти не повысил фактическую точность
- У модели на 124M параметров почти идеальная грамматика, но содержание полно лжи. Очень наглядно видно, что беглость и правильность — разные вещи
- При долгом обучении чаще ломается инфраструктура. В этот раз всё остановилось не из-за модели, а потому что исчезло место, где лежали данные для оценки
Когда создаёшь такую модель с нуля, на собственном опыте понимаешь: ИИ вроде ChatGPT — это машина, предсказывающая продолжение текста, которой объяснили «правила общения». В следующий раз я хочу попробовать сделать модель чуть более практичной.