Я создал с нуля 300-миллионную LLM для RAG на хорватском языке. Она работает на CPU
После предыдущей GPT-2 я решил с нуля создать LLM для хорватского языка на одной RTX 4090. Цель — RAG: модель, которая ищет ответ в переданном ей тексте и отвечает, цитируя одно предложение-основание. И при этом она должна работать в продакшене на CPU.
Сразу к выводам.
- От нуля до готовой модели — около 68 часов на GPU (включая эксперименты). Из них предобучение заняло 51 час
- 320 млн параметров. Правильно отвечает на 71% вопросов по абзацам и на 44% вопросов по длинным текстам порядка 3 000 токенов
- Только на CPU отвечает за 3–16 секунд на вопрос. Текст появляется на экране со скоростью, за которой можно следить глазами
Время, затраченное на обучение
| Этап | Время | Содержание |
|---|---|---|
| Генерация обучающих данных | Около 4,5 часа | 45 тыс. пар вопрос-ответ по Wikipedia и 50 тыс. переводов диалогов с помощью EuroLLM-9B (vLLM) |
| Токенайзер и токенизация | Около 2,5 часа (CPU) | Самостоятельно создан словарь из 32 тыс. единиц для хорватского языка |
| Предобучение | 50 часов 46 минут | 7 млрд токенов. В последних 10% обучения контекст увеличен до 4 096 |
| SFT | Около 35 минут | Обучение отвечать с цитатой и отказываться при отсутствии ответа |
| Обучение с подкреплением (GRPO) | Около 11 часов | 400 шагов, затем ещё 300 шагов настройки |
Самодельный токенайзер представляет хорватский язык примерно вдвое меньшим числом токенов, чем токенайзер GPT-2. То есть в 4 096 токенов помещается около 17 тыс. символов.
Получившаяся модель
| Пункт | Содержание |
|---|---|
| Параметры | 320 млн (24 слоя, размерность 1024) |
| Архитектура | Семейство Llama / Qwen3 (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Длина контекста | 4 096 токенов |
| Формат вывода | Ответ + Izvor: „одно предложение, дословно взятое из контекста“. Если ответа нет: «U tekstu nema odgovora na ovo pitanje.(В тексте нет ответа на этот вопрос)」 |
| Запуск | Расчёт на CPU (около 1,3 ГБ в fp32) |
Кроме того, снаружи добавлен механизм, который программно проверяет, действительно ли сгенерированная цитата есть в контексте; если нет — заменяет ответ на «ответа нет». Важно не доверять модели полностью, а сделать основание ответа проверяемым.
Проблемы, выявленные при разработке
1. Даже без ответа модель каждый раз что-то выдумывает. Сначала я просто обучил её отвечать на вопросы. Точность выросла, но при подаче текста без ответа модель в 100% случаев придумывала правдоподобный ответ. Для RAG это самая неприятная проблема. После обучения цитированию и «отказу» доля выдуманных ответов снизилась до нескольких процентов.
2. Слишком часто отказывается. Я задал оценку для обучения с подкреплением: «ошибся — −0,5, отказался — 0». На сложных длинных текстах модель усвоила, что выгоднее отказаться и уйти от ответа, и стала отказываться в 70% случаев. Она точно находит лазейки в правилах оценки. Когда штраф за отказ изменили на −0,3, маятник качнулся в другую сторону: модель почти перестала отказываться, а доля выдумок выросла до 40%. Получились постоянные качели.
3. Ошибки при копировании цитаты. В длинных текстах ответ бывает верным, но модель меняет порядок слов в цитате или цитирует первое предложение статьи. В длинном контексте и ответ, и цитата были верны примерно в половине случаев.
4. Ошибки, проходящие проверку. Модель точно процитировала добавленную в контекст из другой статьи фразу «родился в ○○» и назвала место рождения другого человека. Цитата настоящая, поэтому такая проверка её не остановит.
5. Недочёты в данных для оценки. Встречались случаи, когда в контексте, который должен был быть «без ответа», оставалась часть ответа: модель отвечала правильно, но это засчитывалось как «выдумка».
Итоговая производительность
По 300 вопросов в каждом наборе. Использовалась модель после 100-го шага скорректированного обучения с подкреплением — в ней лучше всего соблюдался баланс между отказами и ответами.
| Контекст | Верно | Ошибка | Отказ |
|---|---|---|---|
| Абзац (около 100–400 токенов) | 71,3% | 16,7% | 12,0% |
| Длинный контекст (1 500–3 500 токенов) | 44,0% | 20,3% | 35,7% |
| Контекст без ответа | Корректный отказ | Выдумка |
|---|---|---|
| Абзац | 97,7% | 2,3% |
| Длинный контекст | 92,3% | 7,7% |
После прохождения проверки доля правильных среди данных ответов составила 73,8%. До цели в 90% ещё далеко.
Кстати, если давать модели решить один вопрос 8 раз и считать успехом хотя бы один правильный ответ, результат доходил до 91% для абзацев и 74% для длинных текстов (измерено на последнем чекпойнте). До и после обучения с подкреплением эти числа почти не менялись; изменилось то, может ли модель решать задачу каждый раз. Цифры ясно показали: обучение с подкреплением не столько добавляет новые способности, сколько позволяет стабильно решать задачи, которые раньше удавалось решить лишь иногда.
Запуск на CPU
Я сделал тестовый веб-интерфейс и запустил модель только на CPU (i7-13700K). Скорость появления символов на экране соответствует скорости генерации.
Абзац (263 токена): 0,3 секунды до первого символа, около 11 токенов/с, 7 секунд всего
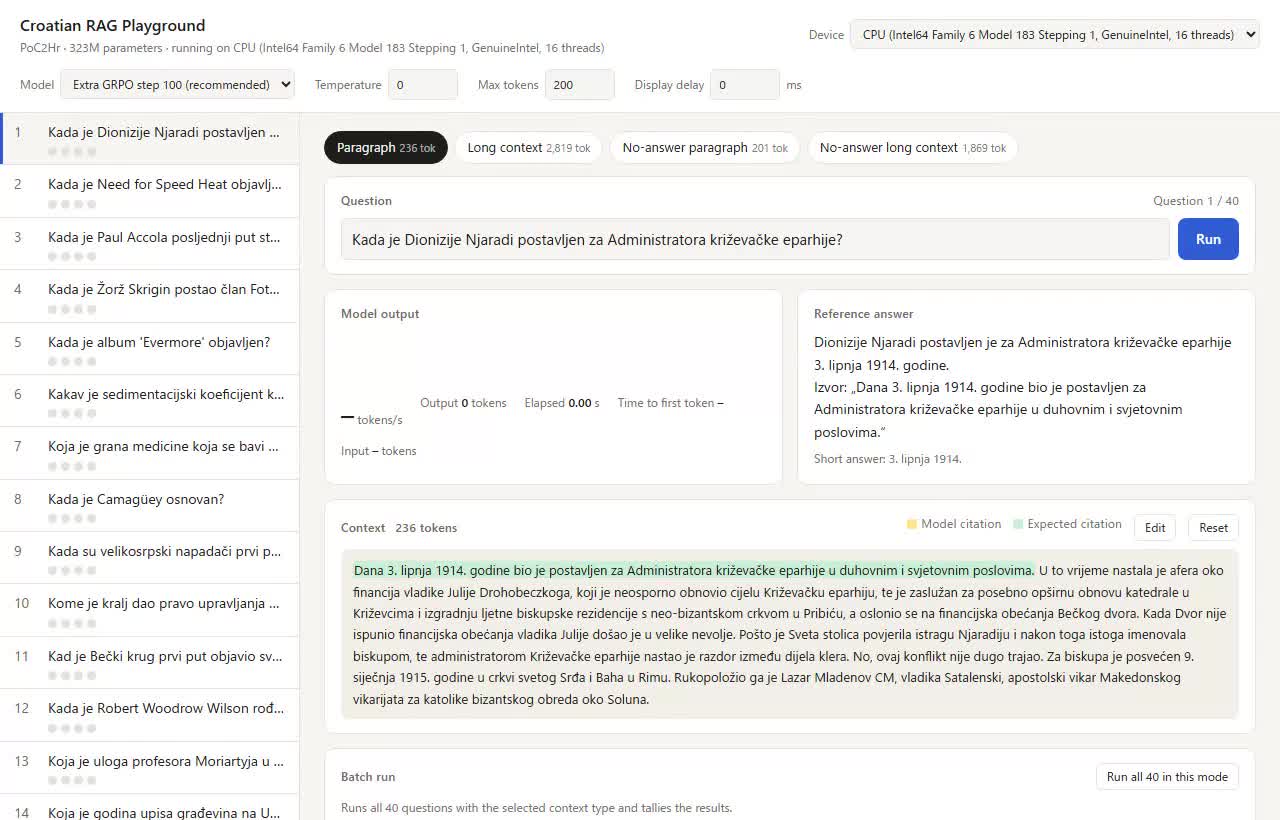
Длинный контекст (3 215 токенов): около 5 секунд на чтение текста, около 5 токенов/с, 19 секунд всего. Жёлтым выделено цитируемое предложение: модель действительно находит правильное одно предложение среди 3 000 токенов
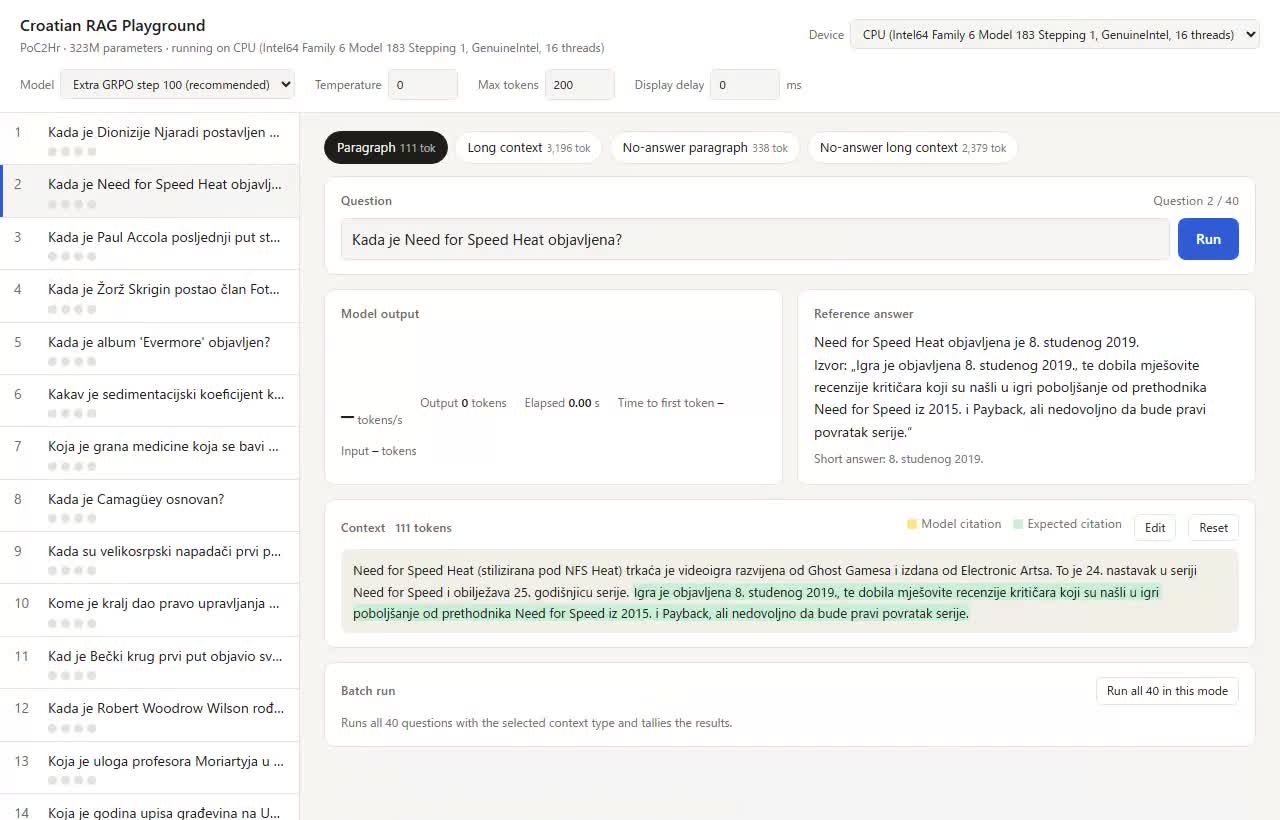
Видео немного медленнее, потому что велась запись. При замере по 20 вопросов без записи получилось: 15 токенов/с и 3,4 секунды на вопрос для абзацев, 7 токенов/с и 16 секунд на вопрос для длинных контекстов. Ответы короткие, около 50 токенов, поэтому даже на CPU скорость, похоже, практична.
Выводы
- Для маленькой модели важнее всего научиться говорить «я не знаю». В RAG уменьшение числа выдумок важнее точности. Сочетание цитаты, отказа и внешней проверки оказалось весьма эффективным
- 320 млн параметров — это предел для длинных текстов. Даже при 8 попытках длинный контекст достигает лишь 74%. Чтобы стремиться к 90% на длинных текстах, желательно около 1 млрд параметров
- Недостаточно проверять лишь то, существует ли цитата на самом деле. Нужно удостоверяться, что в ней есть число или имя из ответа и что подлежащее совпадает с человеком из вопроса
- Модель на 320 млн параметров, работающая на CPU, хорошо подходит для вопросов и ответов по документам, которые нельзя выкладывать в интернет. На ноутбуке или сервере без GPU можно заставить её отвечать, опираясь только на локальные документы. Скорость — от нескольких до десятков секунд на вопрос; после квантизации она, вероятно, станет ещё выше (не проверено)
Далее я хочу попробовать версию на 1 млрд параметров и нацелиться на 90% в длинном контексте.