Полное руководство по Qwen-Image 2.1: генерация, редактирование и прозрачные PNG на 7B, 100 популярных примеров с Reddit
20 сентября 2026 года команда Qwen представила модель генерации изображений «Qwen-Image 2.1». Её ключевая особенность — объединение в одной модели генерации изображений по тексту, редактирования с использованием референсов, компоновки нескольких изображений, локального редактирования, а также генерации и редактирования прозрачного фона (RGBA). Генеративная часть содержит 7 млрд параметров. Вместо бесконечного наращивания масштаба разработчики сделали ставку на размер и эффективность, удобные для локального использования.
Главный вывод: Qwen-Image 2.1 интереснее не как модель, которая рисует идеальный кадр с нуля, а как производственный инструмент, позволяющий бережно изменять существующие изображения, сочетать несколько материалов и править нужные детали. На Reddit особенно хвалят редактирование, согласованность персонажей, компоновку товаров, аутпейнтинг и прозрачные ассеты. При этом пользователи сообщают о явных слабостях: кистях рук, лицах на дальнем плане, шуме мелких деталей, провалах в чёрном, реставрации старых фото и аниме-стилистике.
В этой статье собраны все функции по официальным материалам, а также разобраны основные ветки Reddit и составлена подборка «100 примеров» генерации и редактирования, вызвавших обсуждение. Под 100 пунктами подразумеваются не 100 независимых публикаций, а отдельные темы и операции, проверенные в нескольких популярных постах, галереях и рабочих процессах.
Что такое Qwen-Image 2.1
Qwen-Image 2.1 — интегрированная модель генерации и редактирования изображений семейства Qwen. Согласно официальному описанию, генеративная часть использует 32-слойный Single-Stream DiT и 7 млрд параметров. Qwen3-VL 8B преобразует текстовые инструкции и условные изображения в общее представление, а 64-канальный RGBA VAE отвечает за 16-кратное пространственное сжатие и нативную прозрачность.
Официально заявлены четыре ключевых улучшения.
- Компактность и эффективность: mixed-granularity attention и повторное использование prefix KV cache улучшают баланс качества и вычислительной стоимости.
- Единая генерация и редактирование: обычные и прозрачные изображения можно создавать и редактировать одной моделью.
- Многофункциональное редактирование: до 10 референсных изображений, локальные указания масками и разметкой, сохранение идентичности людей и товаров.
- Фактура и эстетика: улучшены типографика, портретное освещение и мелкие текстуры.
Источники: официальный блог Qwen, официальный GitHub, документация Diffusers
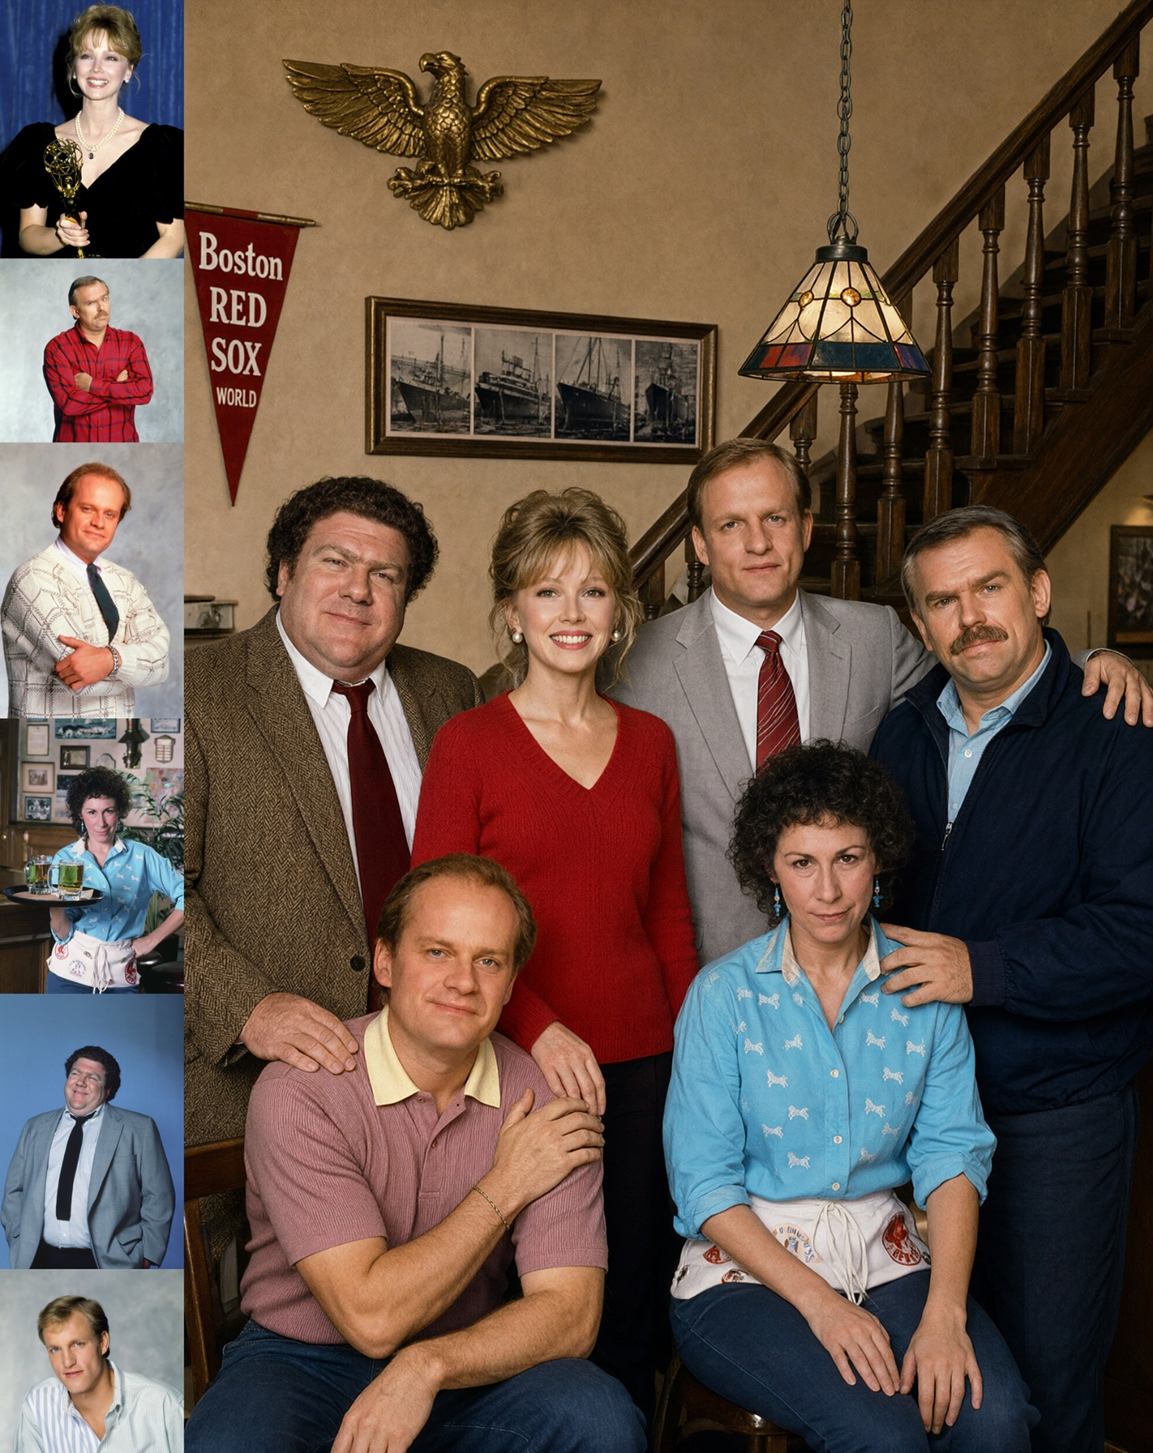
Обзор всех возможностей
1. Генерация изображений по тексту
Поддерживается обычный Text-to-Image. Модель работает не только с короткими запросами, но и со сложными длинными описаниями на естественном языке через Qwen3-VL: композицией, светом, материалами, передним и задним планом, текстовыми элементами. В официальных примерах базовым значением служат 40 шагов; сообщество также тестирует ускоряющие LoRA на 8–16 шагах и настройки на 30–40 шагов с приоритетом качества.
2. Редактирование изображений
Одновременно подаются входное изображение и текстовая инструкция; можно менять цвет, погоду, фон, одежду, позу, материал, освещение, угол камеры и другое. На Reddit часто считают, что редактирование у модели сильнее чистого T2I.
3. До 10 референсных изображений
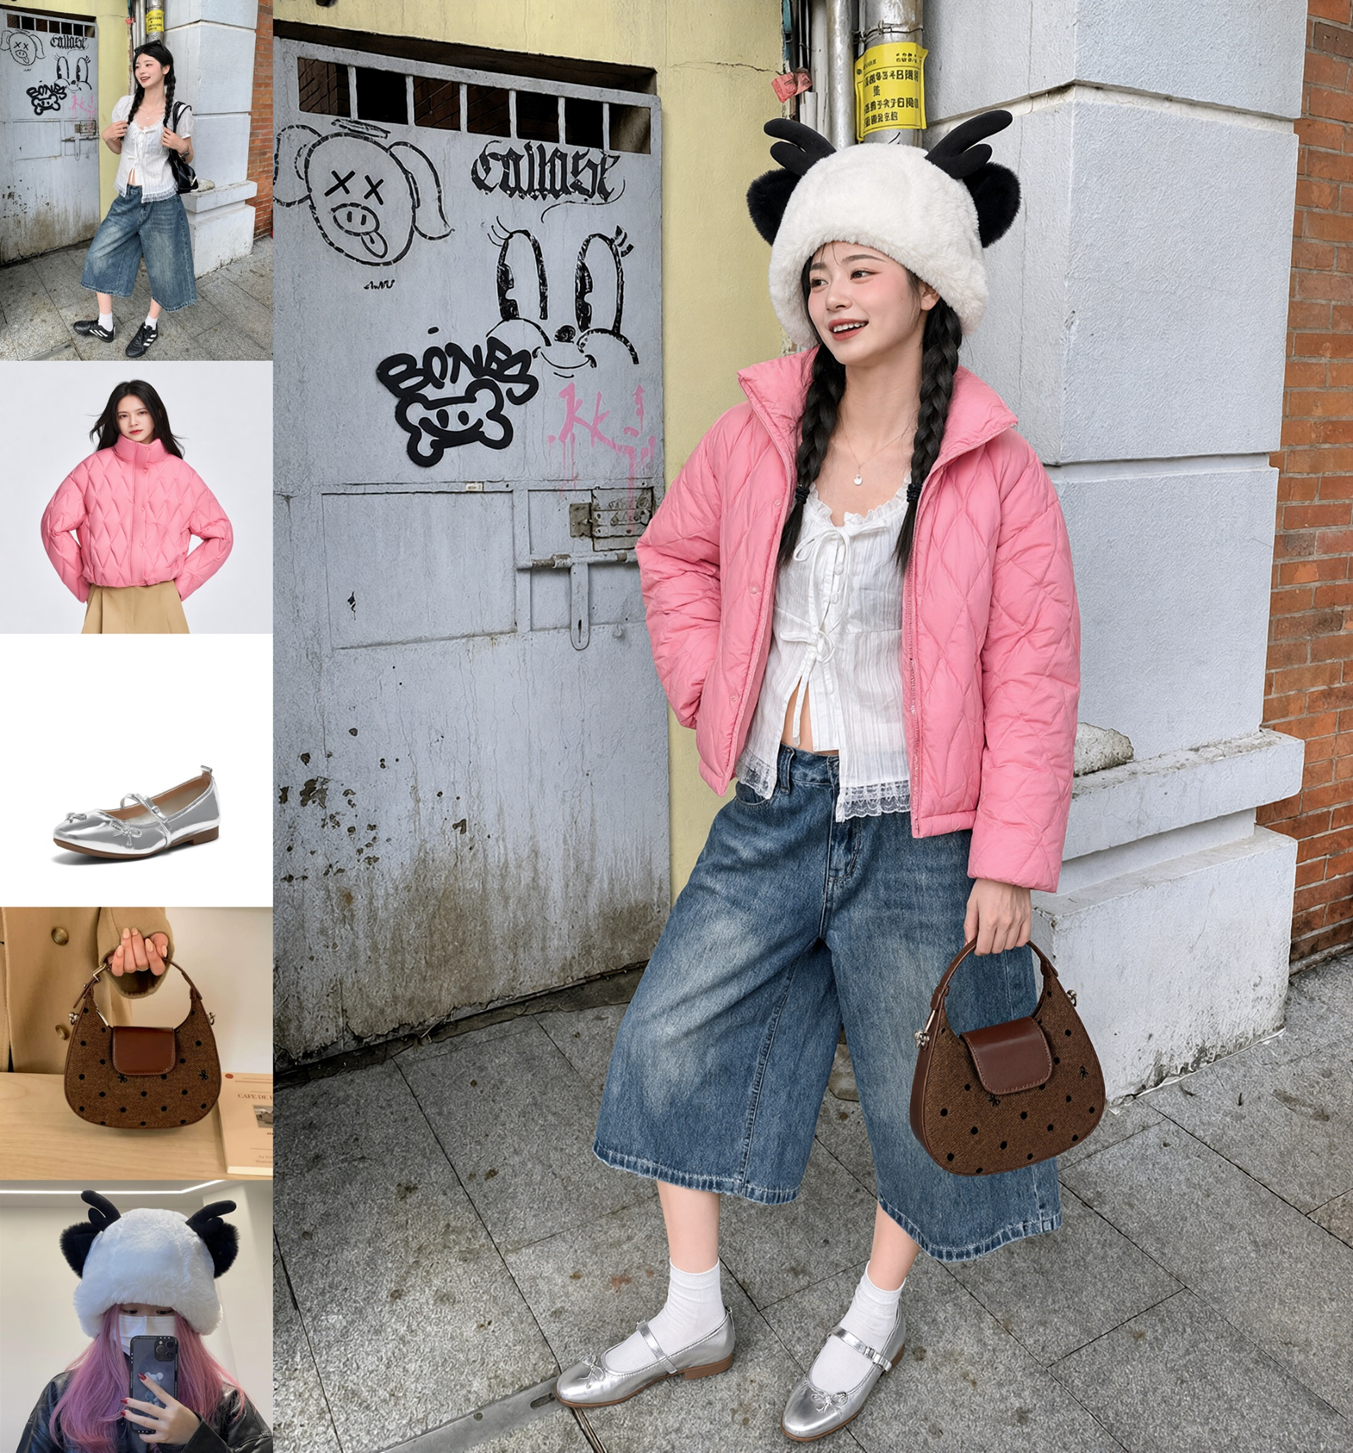
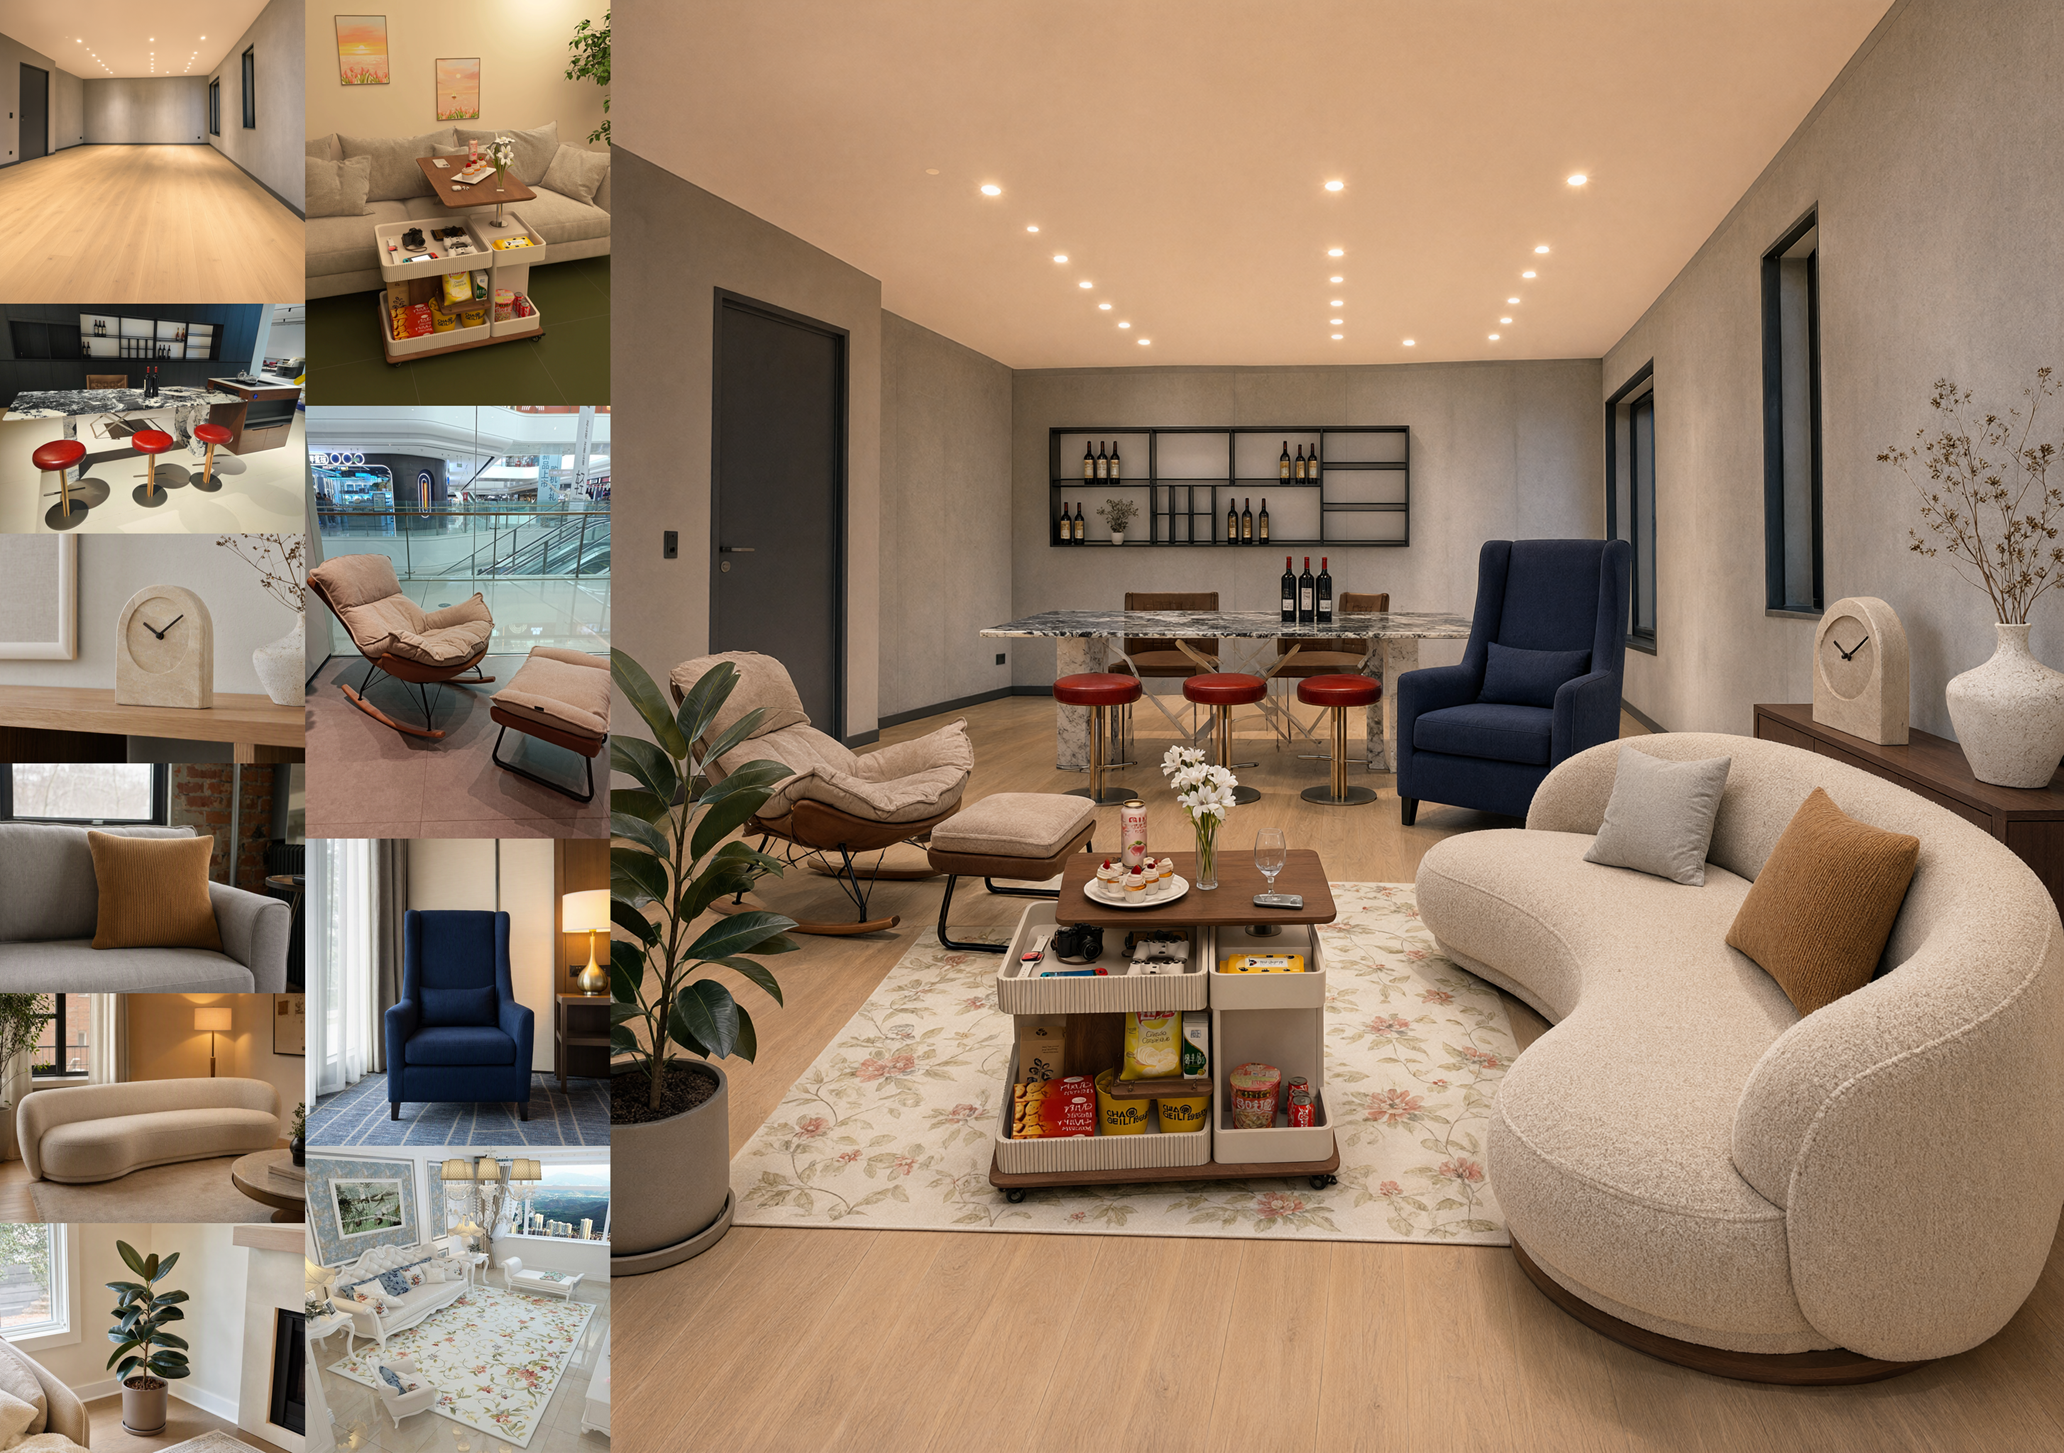
Людей, одежду, обувь, сумки, головные уборы, мебель, товары и другие объекты можно брать из разных изображений и объединять в одной сцене. Официальные примеры включают групповое фото с лицами шести людей, виртуальную примерку из пяти материалов и дизайн интерьера с десятью предметами мебели. Однако сообщество также отмечает, что с ростом числа референсов чаще возникают конфликтующие инструкции и смешение атрибутов.
4. Нативный RGBA и прозрачный фон
Модель не просто удаляет фон на постобработке, а может напрямую создавать изображения с прозрачным каналом. Это подходит для вырезания объектов из фотографий, редактирования формы прозрачных элементов и создания прозрачных ассетов из нескольких компонентов.
5. Локальное редактирование и маски
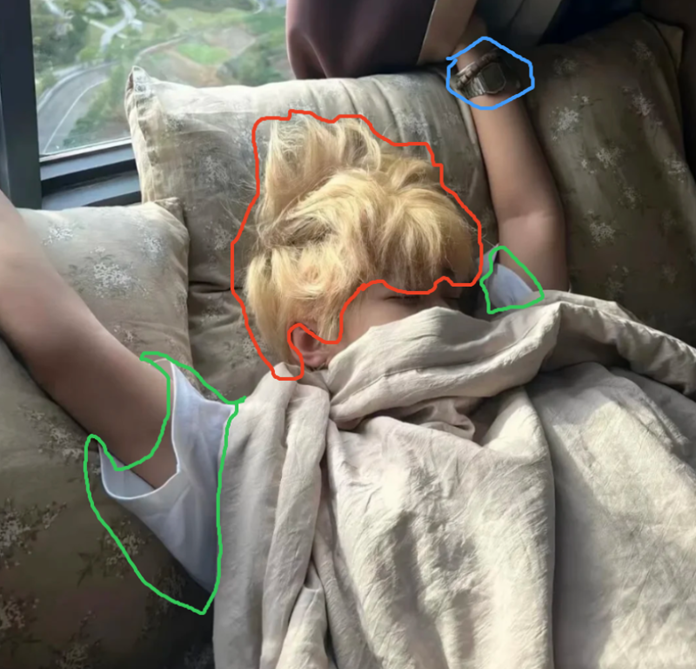
Зоны изменений можно задавать кругами, закрашенными аннотациями и отдельными масками. В ComfyUI пользователи рисуют цветом прямо на изображении и дают инструкции вроде «измени одежду только в красной области». В сочетании с LanPaint можно выполнять инпейтинг не только цветов, но и самого альфа-канала.
6. Аутпейнтинг
Холст можно расширять вверх, вниз, влево и вправо, дорисовывая пустые области в контексте исходного изображения. На Reddit привлекли внимание сообщения о возможности расширять изображение сразу в нескольких направлениях и делать это быстрее традиционных специализированных workflow.
7. Сохранение идентичности
Основное применение — сохранять лицо, одежду, позу человека, форму товара или элементы бренда, меняя только фон либо отдельные атрибуты. Это особенно обсуждается применительно к листам персонажей и последовательным кадрам, хотя при экстремальных ракурсах, яркой мимике и длинных сериях необходима проверка дрейфа.
8. Отрисовка текста и дизайн
Поддерживаются изображения с постерами, упаковкой, вывесками и типографикой. Популярен workflow, в котором композиция, информационная иерархия, размер текста и отступы сначала структурируются внешней LLM. Однако есть сообщения, что в англоязычных инфографиках может появляться нежелательный китайский текст.
9. Переписывание промптов
В официальном репозитории есть prompt rewriter для T2I и I2I. Он разворачивает краткий запрос в детальную композицию, а при редактировании переписывает инструкцию так, чтобы сохранялось всё вне зоны изменения. Сообщество также сообщает, что шаблоны под конкретные задачи иногда лучше стандартного rewrite.
10. Ускорение, экономия памяти и квантизация
Поддерживаются CPU offload в Diffusers, prefix KV cache в vLLM-Omni, CUDA Graph, FP8, tensor parallelism, memory offload и оптимизированные ядра SGLang. Для ComfyUI появились варианты BF16, INT8 ConvRot, GGUF и 4-bit. Пользователи сообщают примерно о двукратном ускорении с 4-step LoRA и о кастомных нодах для prompt expansion на 8 GB VRAM, но компромисс между скоростью и качеством следует обязательно проверять.
11. Поддерживаемые среды
Указаны официальная реализация, Hugging Face Diffusers, ComfyUI, vLLM-Omni, SGLang-Diffusion, LightX2V и ModelScope. Также представлены примеры ROCm для AMD Radeon и поддержка нескольких типов чипов через FlagOS.
12. Важные условия лицензии
Веса модели опубликованы, но распространяются не по Apache 2.0, а по «Qwen Research License Agreement». В официальной лицензии прямо сказано, что для коммерческого использования требуется отдельная коммерческая лицензия. Есть также обязательства по уведомлению при распространении и указанию «Built with Qwen» либо «Improved using Qwen» в документации производных AI-моделей. Перед внедрением в работу обязательно изучите оригинальный текст.
Источник: официальная лицензия
50 наблюдений по официальным примерам
Ниже представлены 50 официальных образцов Qwen-Image 2.1, опубликованных командой Qwen, с привязкой к темам, которые особенно обсуждались на Reddit. Это не только «красивые картинки»: здесь есть входные данные, результаты редактирования, маски, несколько референсов, смена камеры и подготовка материалов — чтобы показать, на каких этапах производства модель полезна.
Прозрачные ассеты и генерация иллюстраций
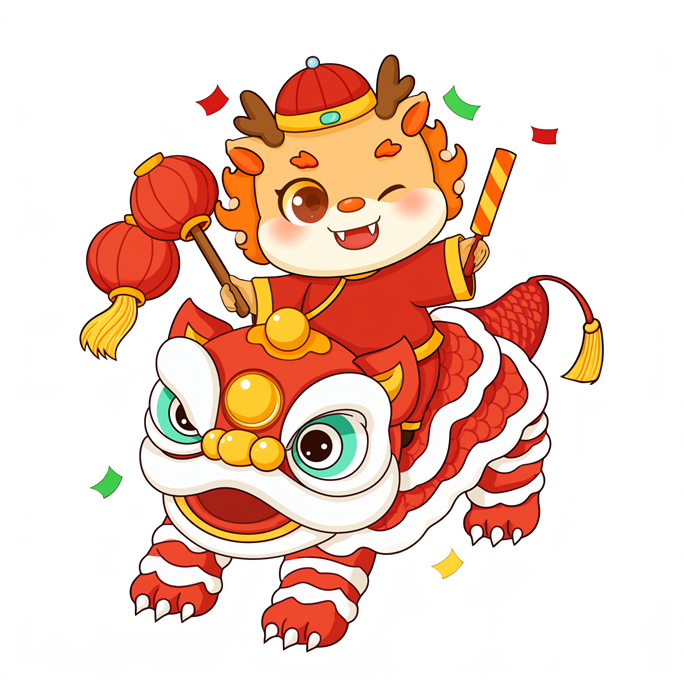
Пример 1: прозрачная иллюстрация с мотивом танца льва. Пример одновременной работы с детализированным контурным декором и альфа-фоном.
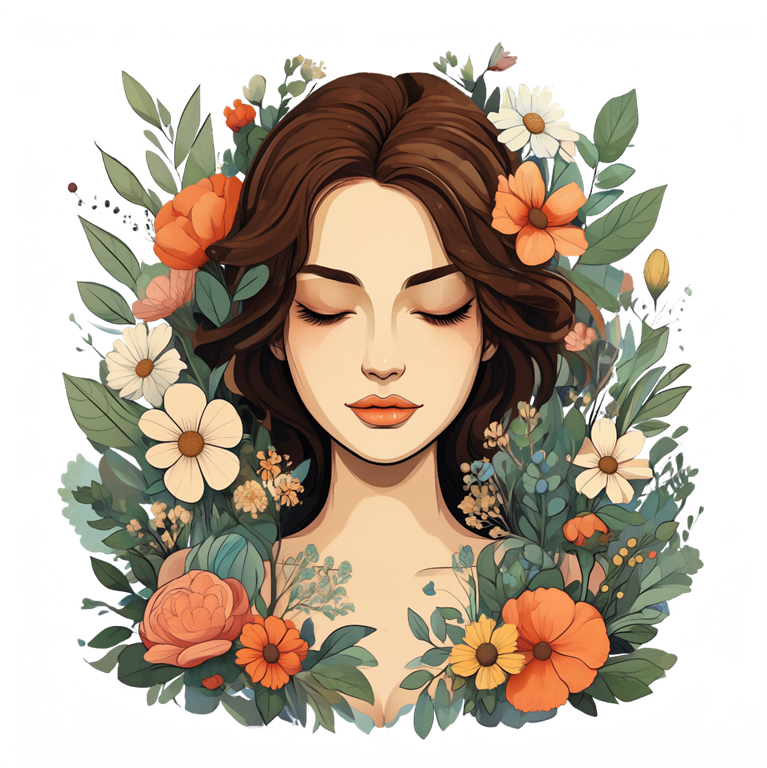
Пример 2: декоративная иллюстрация женщины в окружении цветов. Включает сложные границы волос, лепестков и листьев.
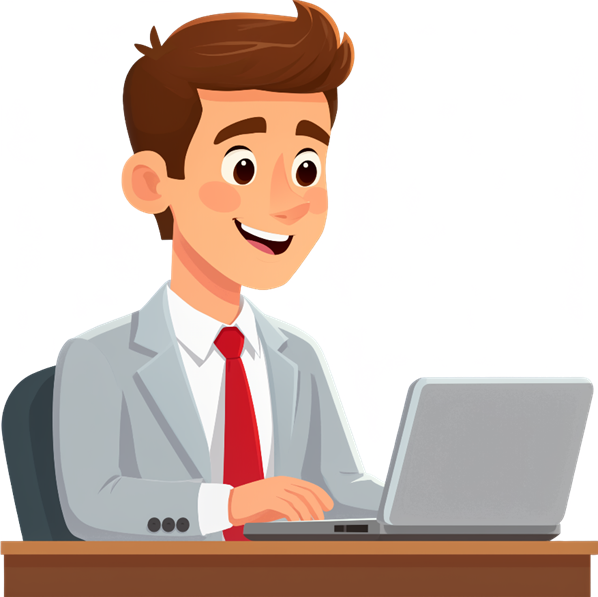
Пример 3: деловой персонаж с ноутбуком. Вырезанная иллюстрация для веба и презентаций.
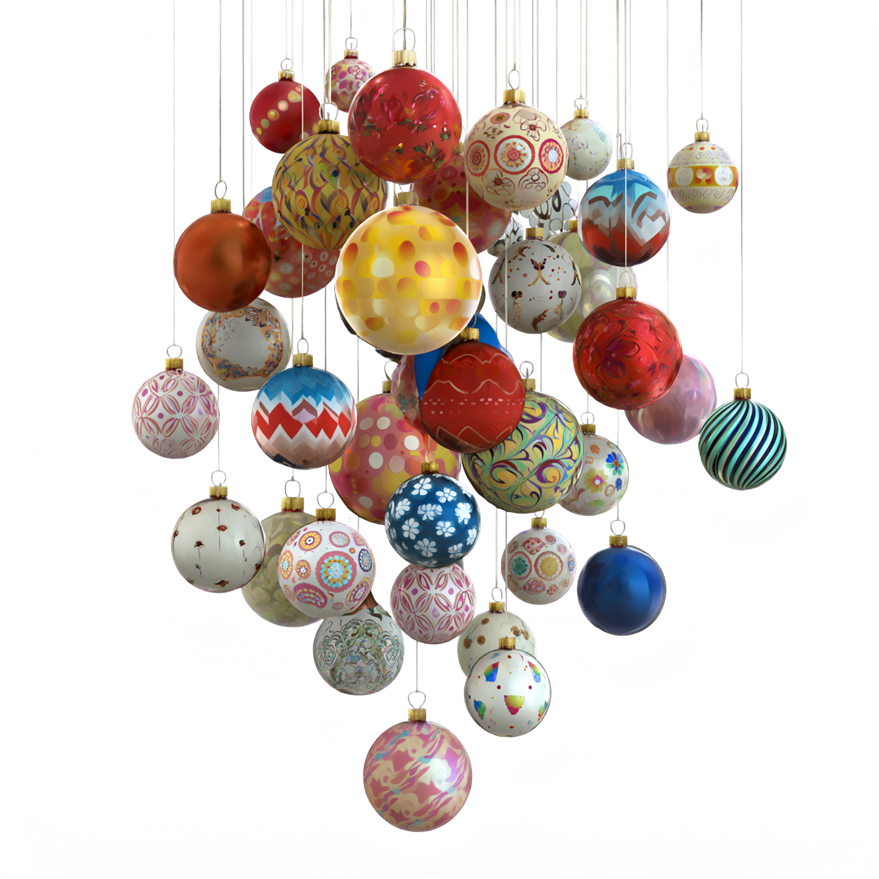
Пример 4: несколько подвесных украшений. Объединение полупрозрачности, тонких нитей и различных материалов в одном изображении.
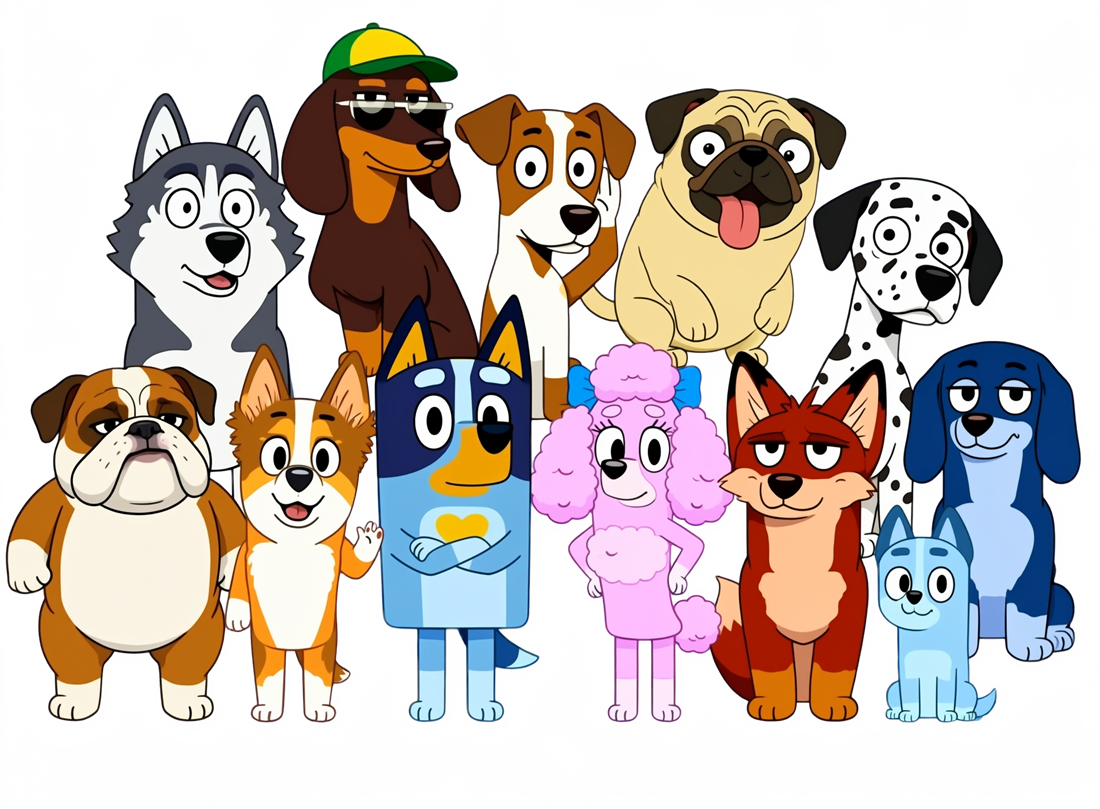
Пример 5: множество персонажей-собак. Пример различения нескольких субъектов и групповой композиции.
Редактирование изображений и замена текста
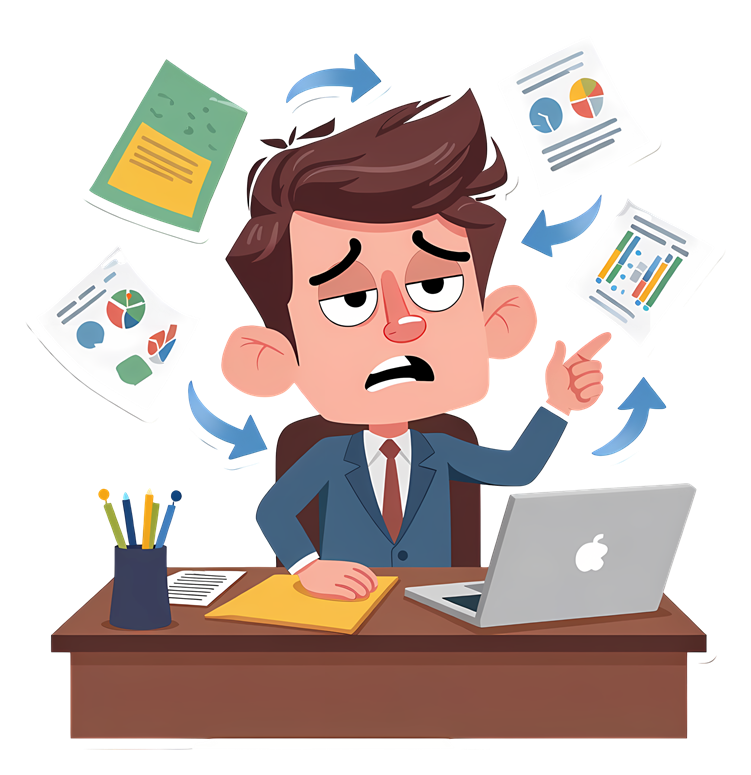
Пример 6: исходное изображение уставшего офисного работника. Условное изображение для сравнения со следующим результатом редактирования.
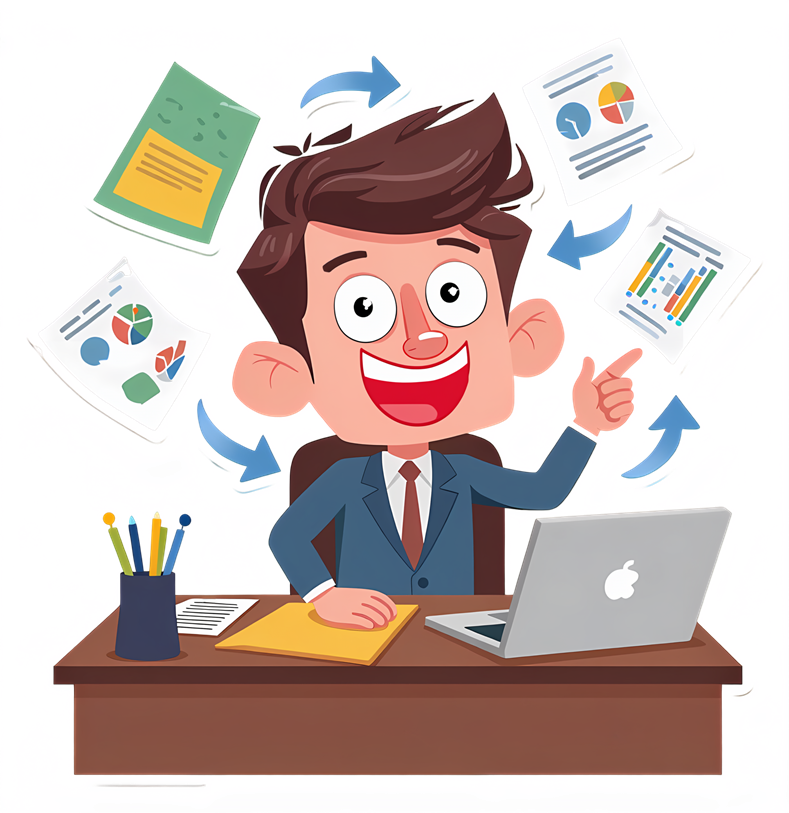
Пример 7: офисный работник с изменёнными выражением и атмосферой. Эмоция персонажа изменена при сохранении макета.
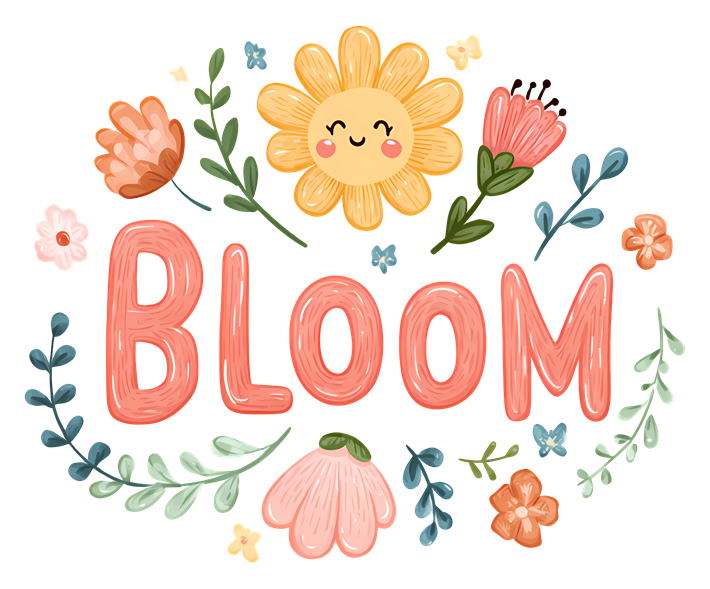
Пример 8: цветочное слово «BLOOM». Базовый пример текста, декора и центрального размещения.
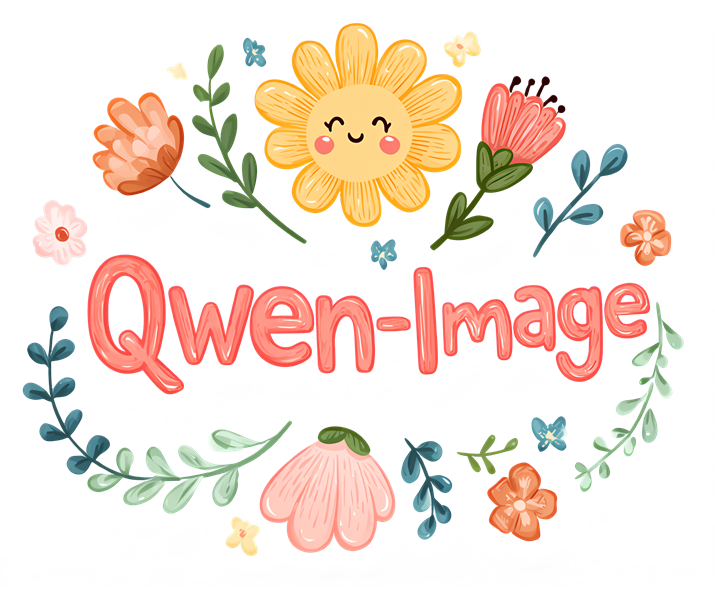
Пример 9: замена текста на «Qwen-Image». Типографическое редактирование с сохранением цветочного стиля.
Пример 10: дневная фотография башни. Входной пример для изменения времени суток и фона.
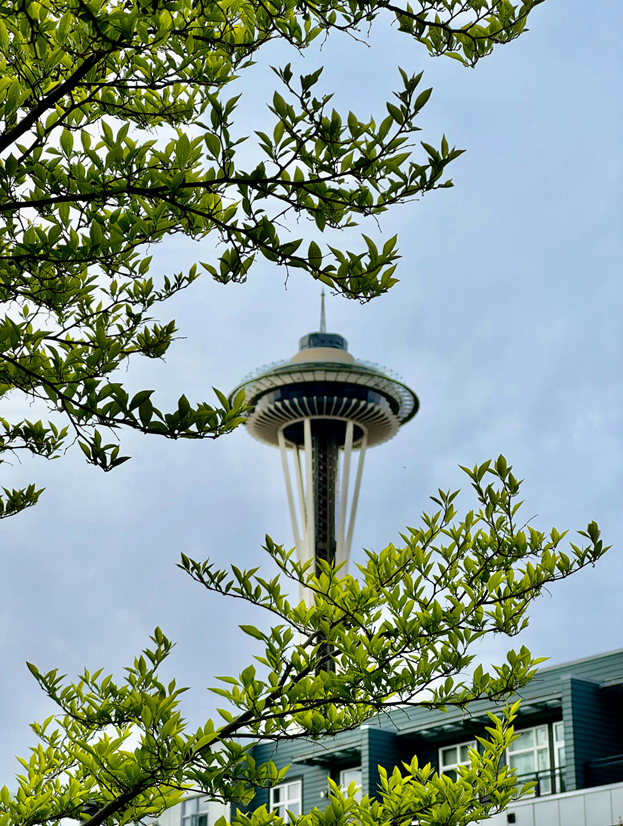
Фон, время суток и несколько людей
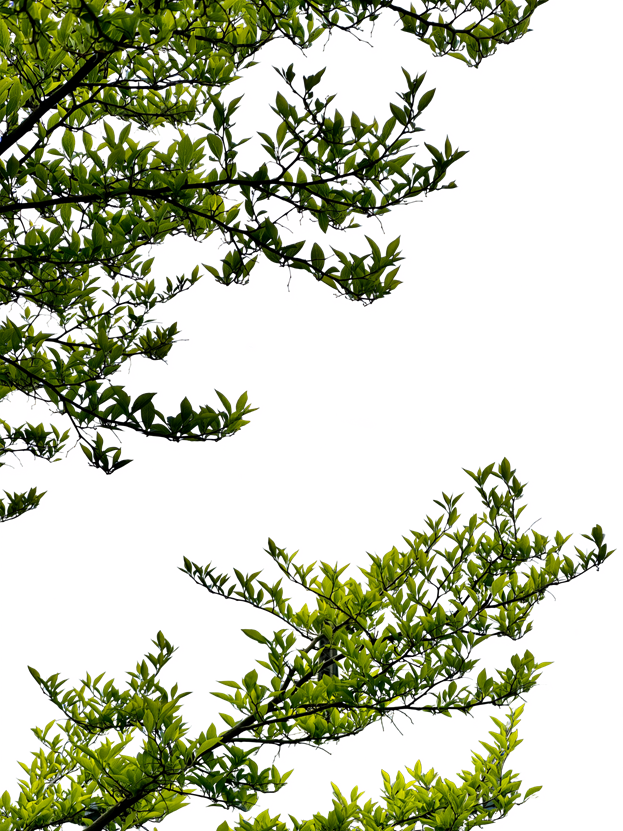
Пример 11: цветущее дерево ночью. Демонстрация редактирования дневной фотографии в ночной пейзаж с другой атмосферой.
Пример 12: групповое фото по нескольким референсам людей. Показывает ключевую возможность работы с десятью референсами.
Пример 13: образ по нескольким референсам человека и одежды. Близко к идее виртуальной примерки.
Пример 14: интерьер из множества изображений мебели. Размещение товаров из каталога в комнате.
Пример 15: цветовые указания вокруг кота. Входное изображение для локального задания с нарисованными аннотациями.
Локальное редактирование, маски и композитинг
Пример 16: изменение только указанного кота. Объект заменён с сохранением постели и человека.
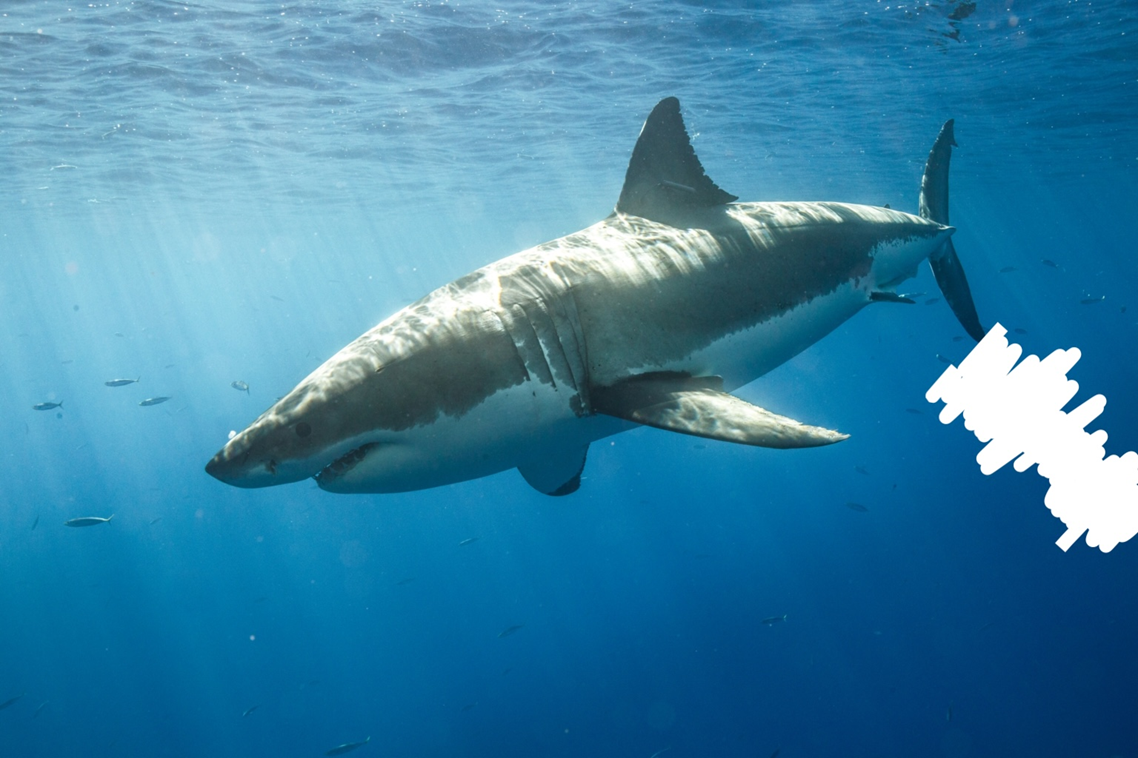
Пример 17: акула под водой с локальным указанием. Вход для редактирования рисованием непосредственно по объекту.
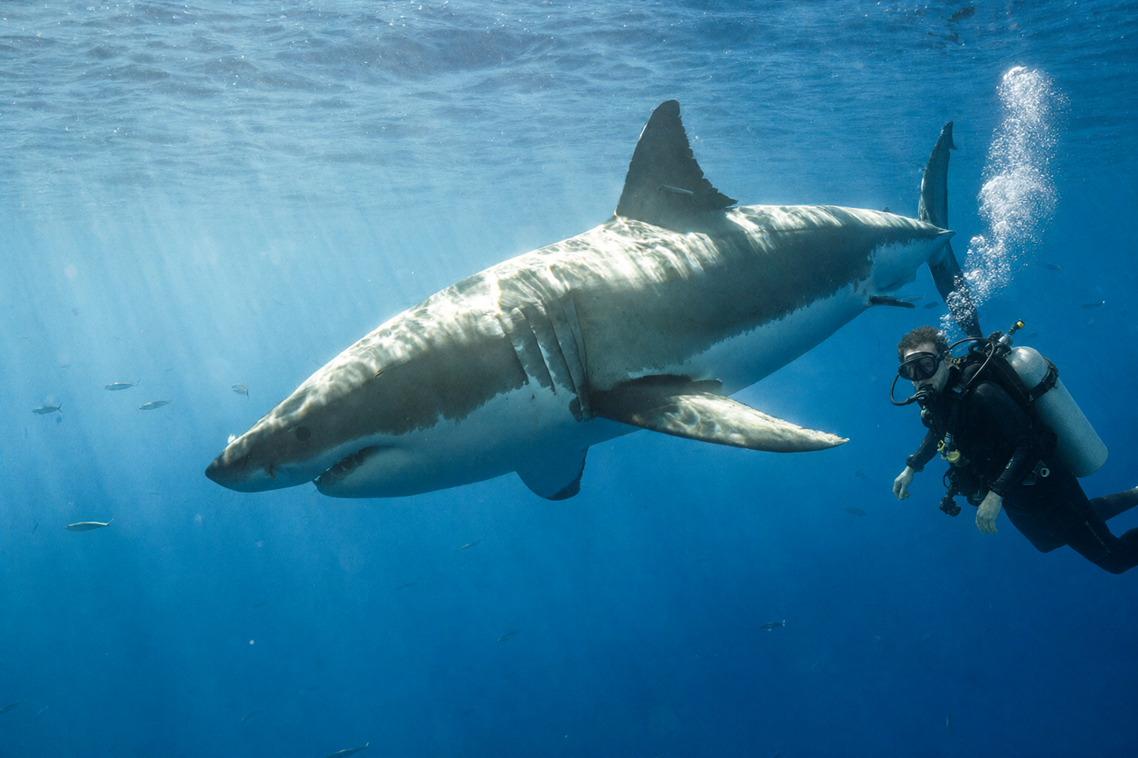
Пример 18: подводная сцена с добавленным дайвером. Композитинг с согласованными подводным светом и масштабом.
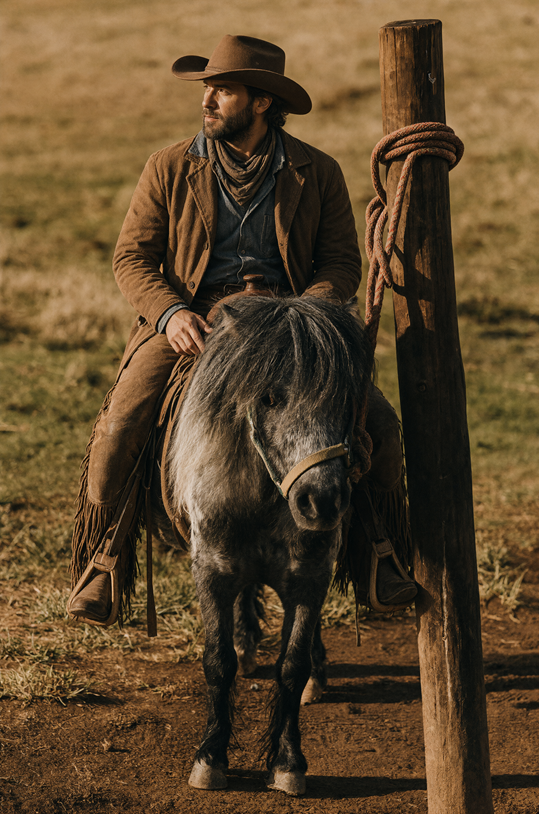
Пример 19: исходная фотография человека на осле. Базовая фотография для масочного редактирования.
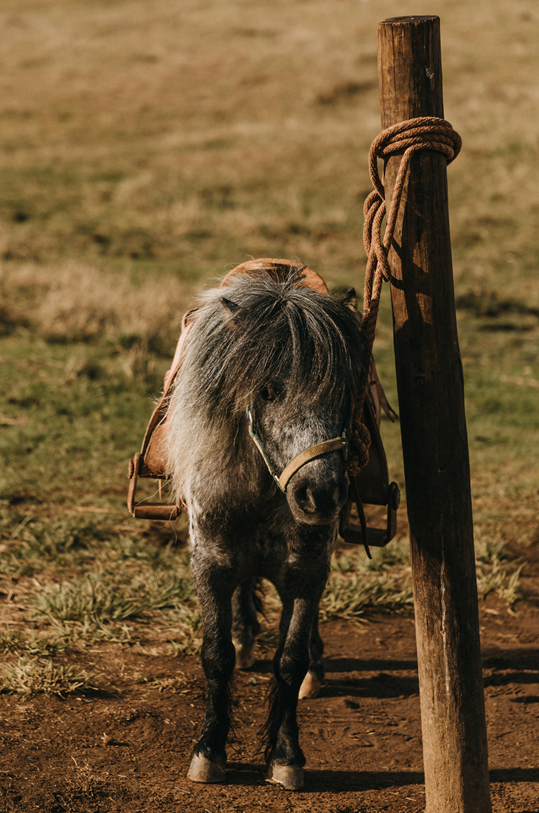
Пример 20: маска, указывающая человека и осла. Альтернативный способ явно задать зоны изменений чёрно-белой маской.
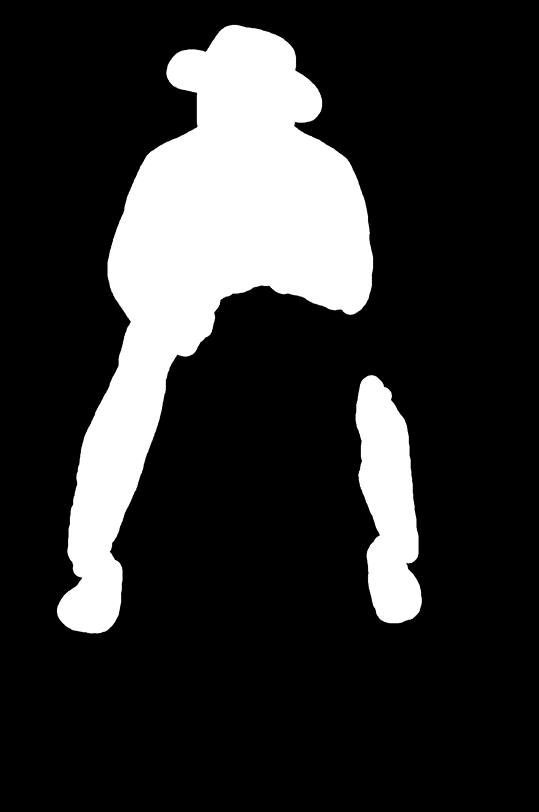
Перемещение людей и сохранение лица
Пример 21: результат редактирования человека по маске. Позволяет также сравнить согласованность с фоном травяного поля.
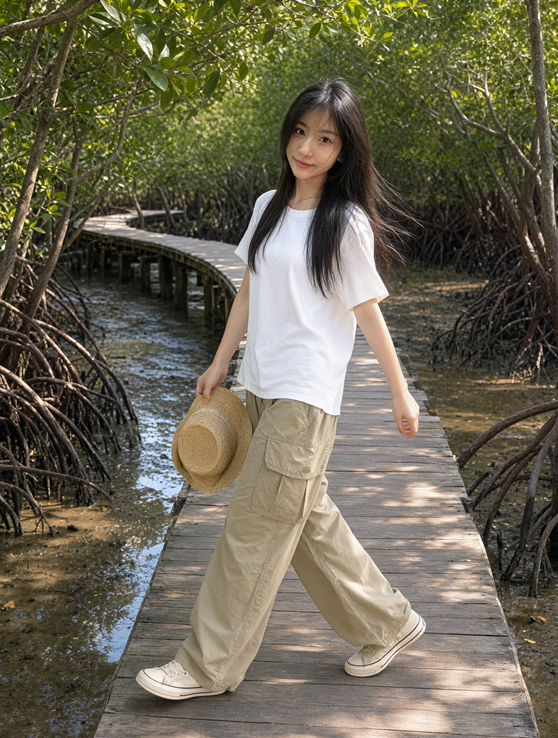
Пример 22: портрет для референса лица. Базовое изображение для последующей генерации фигуры в полный рост и новой среды.
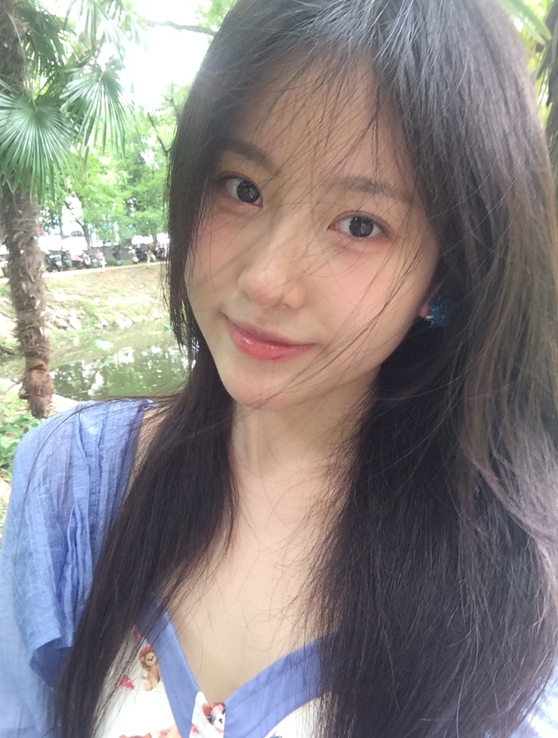
Пример 23: перенос референсного человека в уличную фотографию в полный рост. Лицо и одежда перенесены в новую композицию.
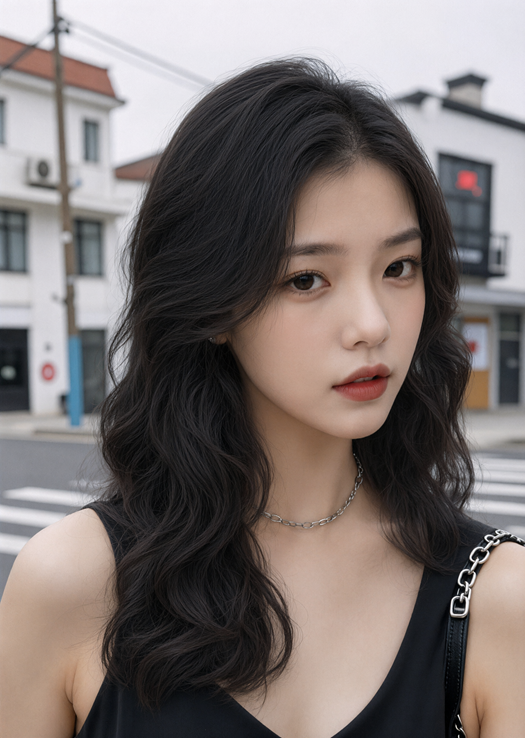
Пример 24: фотография лица почти анфас. Входные условия для редактирования причёски.
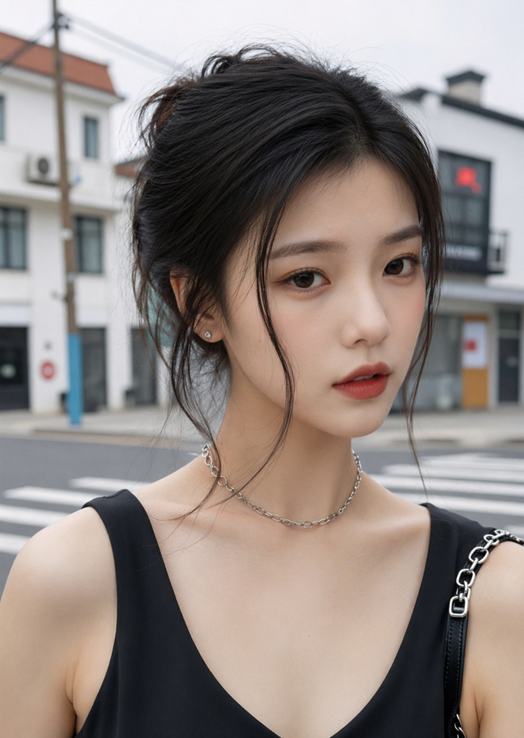
Пример 25: фотография лица с изменённой причёской. Черты лица и фон сохранены, волосы сделаны длиннее.
Позы, сцены и товарные фотографии
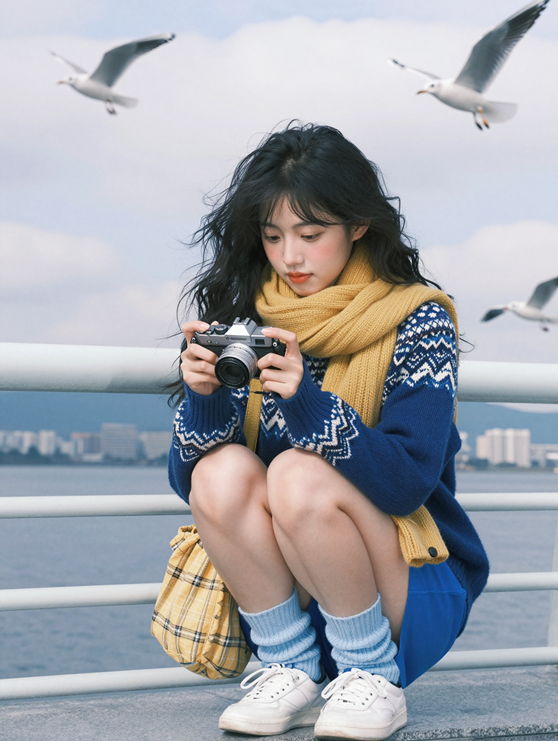
Пример 26: человек на корточках в порту. Сложная поза, аксессуары и дальний план.
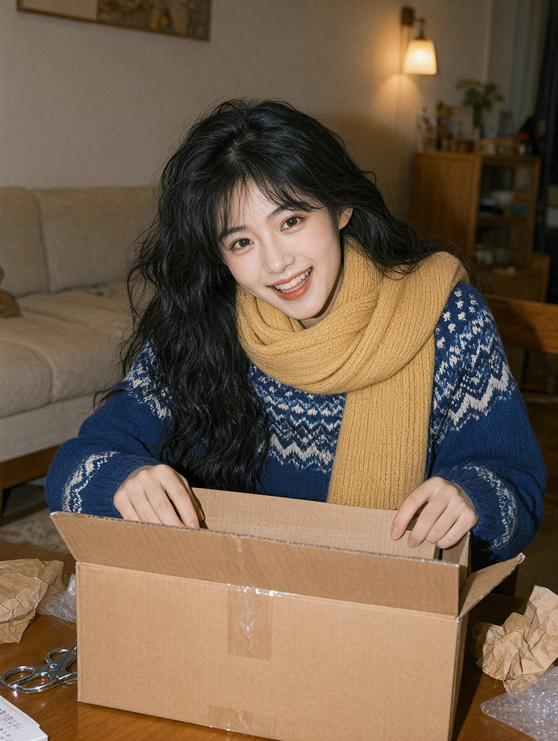
Пример 27: человек открывает коробку в помещении. Композиция для оценки пальцев, коробки и перекрытий тела.
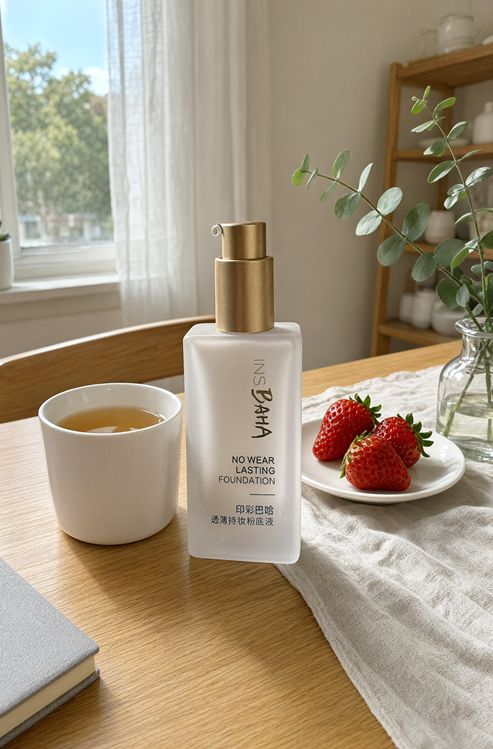
Пример 28: косметика в руке. Товарная фотография с текстом на этикетке и касанием пальцев.
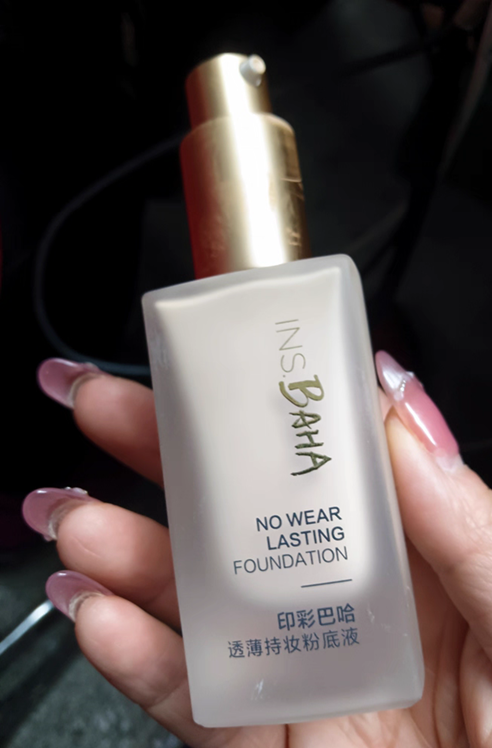
Пример 29: превращение косметики в интерьерный товарный кадр. Добавлены естественный свет, стол и пищевой реквизит.
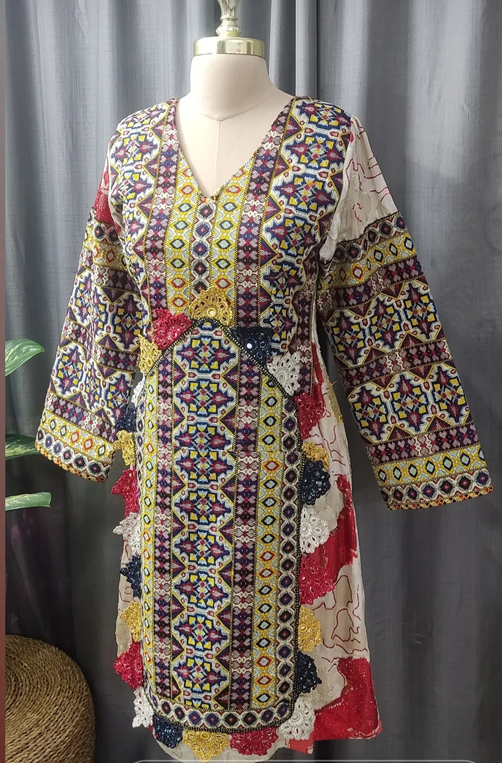
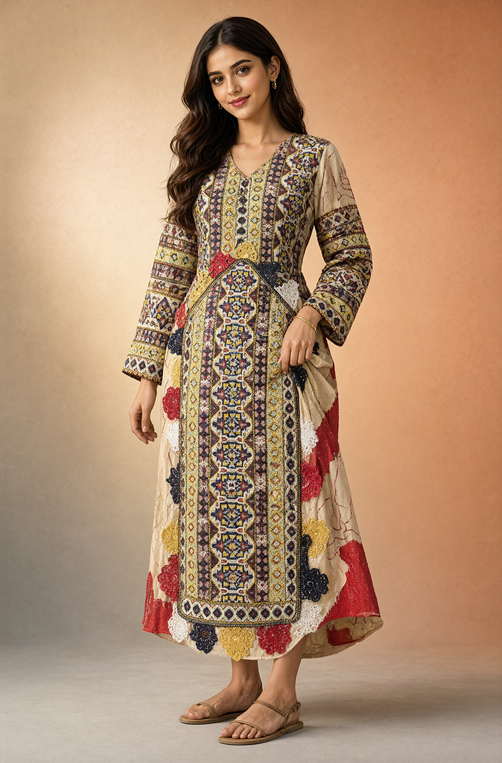
Пример 30: одежда на манекене. Товарный референс для следующей генерации примерки на человеке.
Виртуальная примерка и композитинг аксессуаров
Пример 31: примерка референсной одежды на человеке. Узор, длина и силуэт адаптированы к телу.
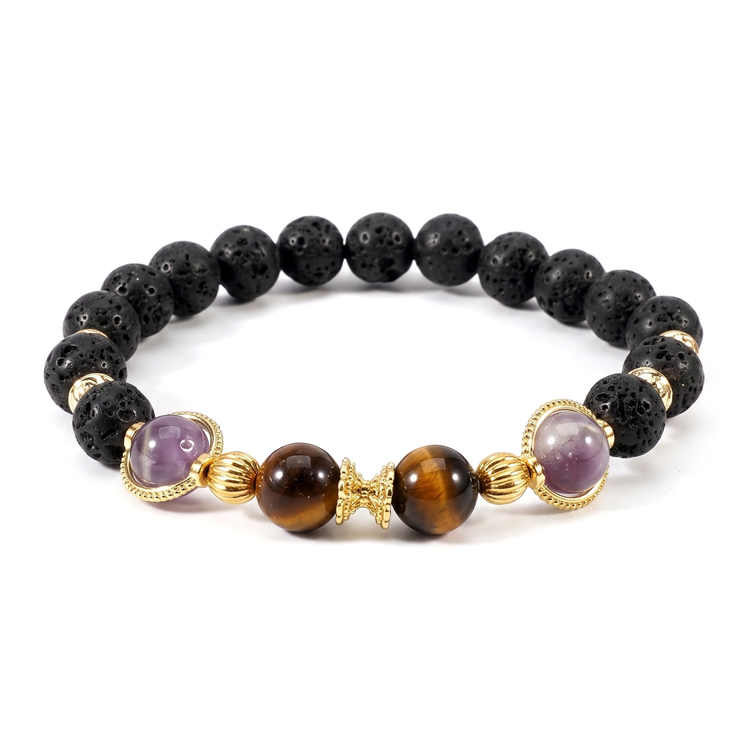
Пример 32: товарная фотография отдельного браслета. Условное изображение для композитинга при ношении.
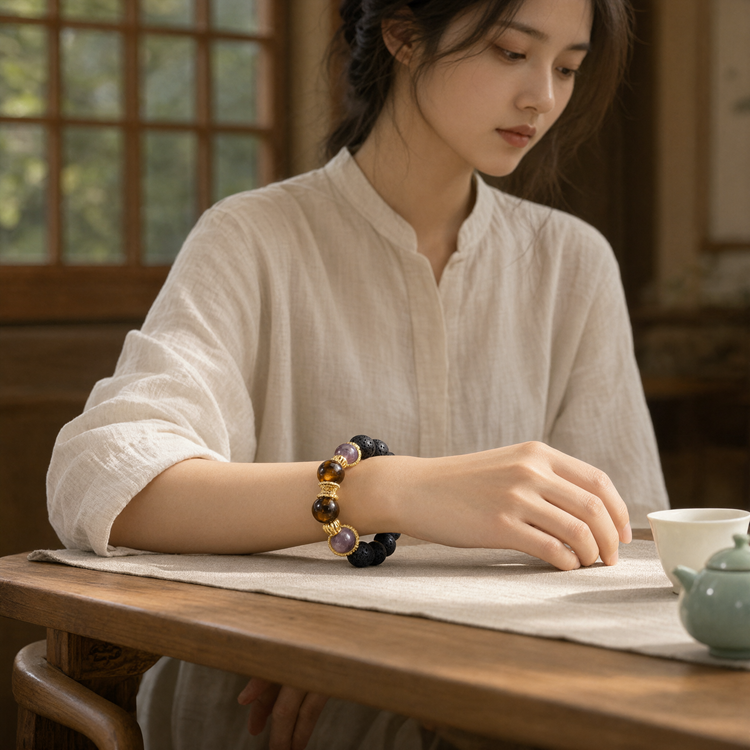
Пример 33: браслет на запястье человека. Контакт с кожей и тень согласованы естественно.
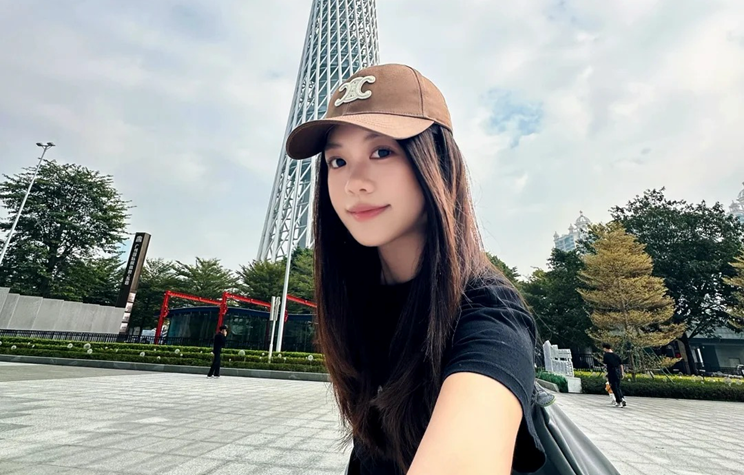
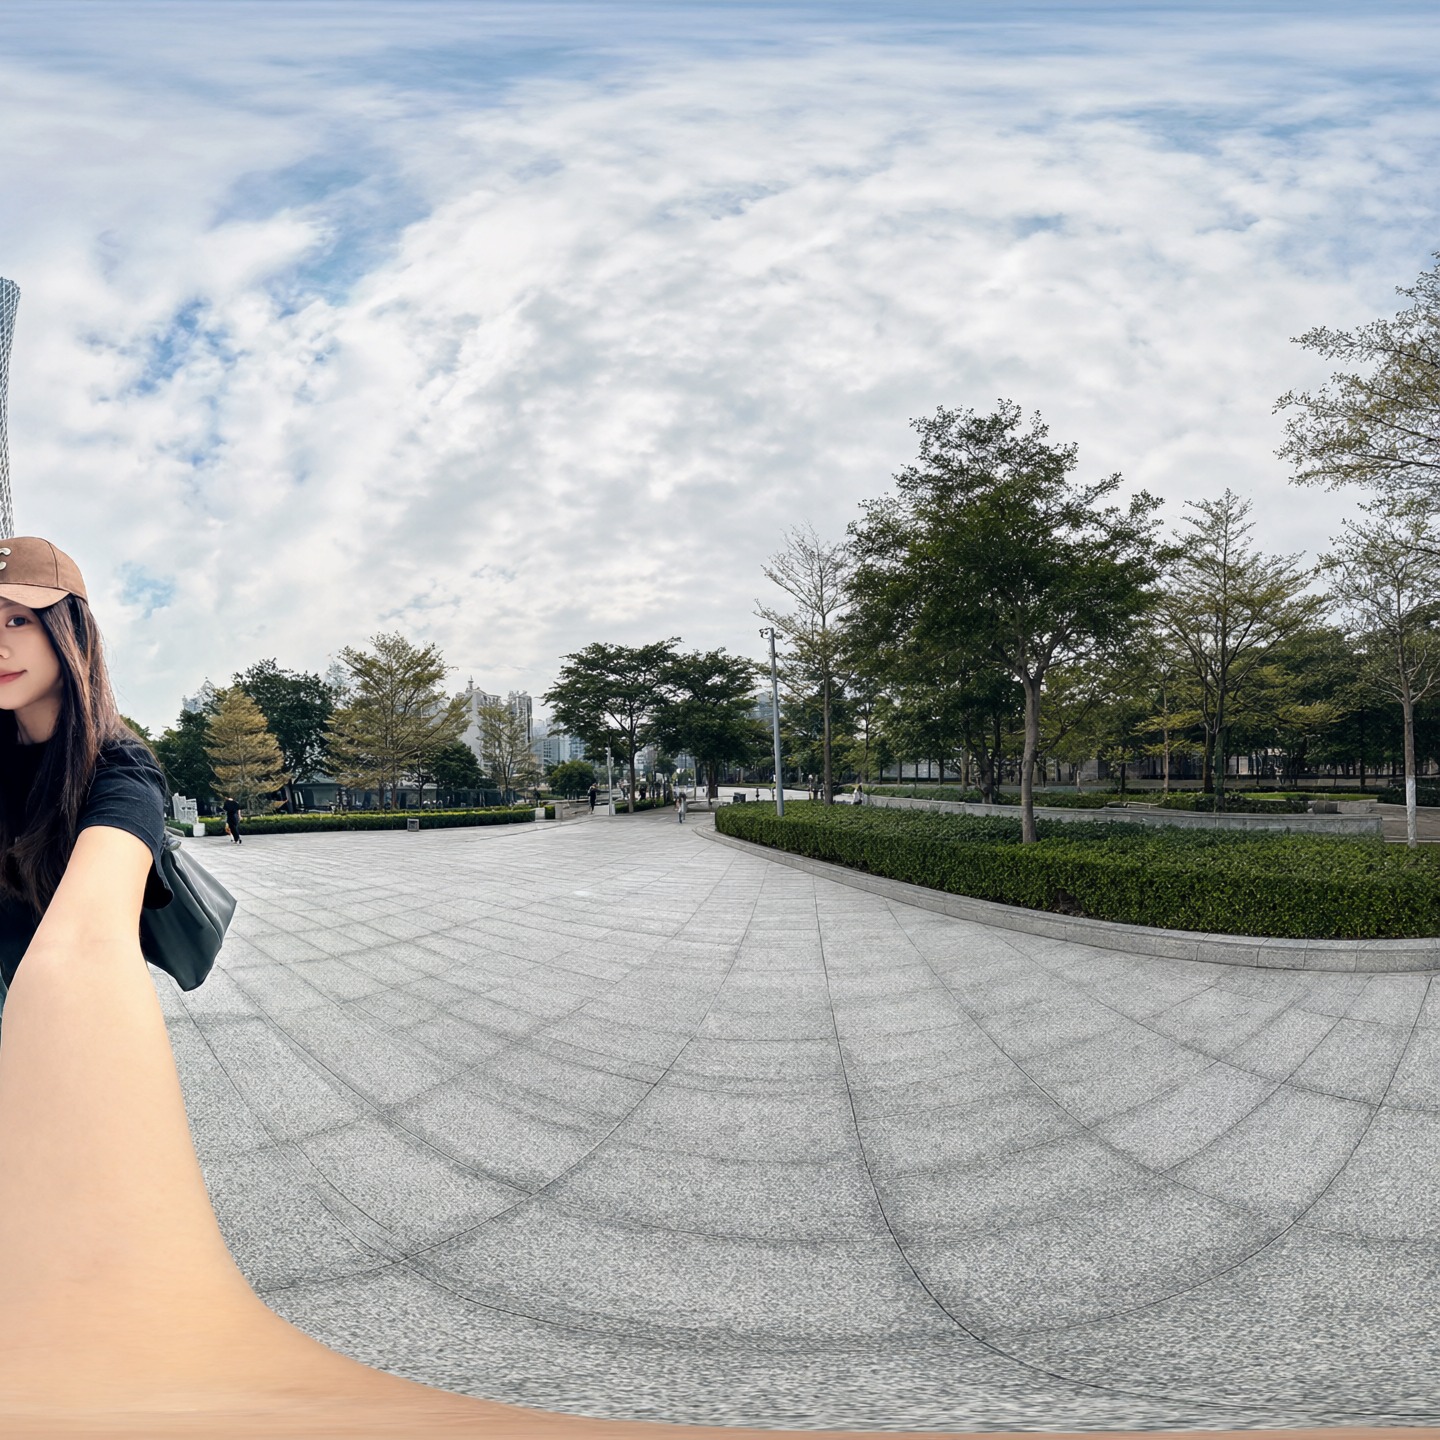
Пример 34: селфи перед башней. Входное фото для изменения точки зрения.
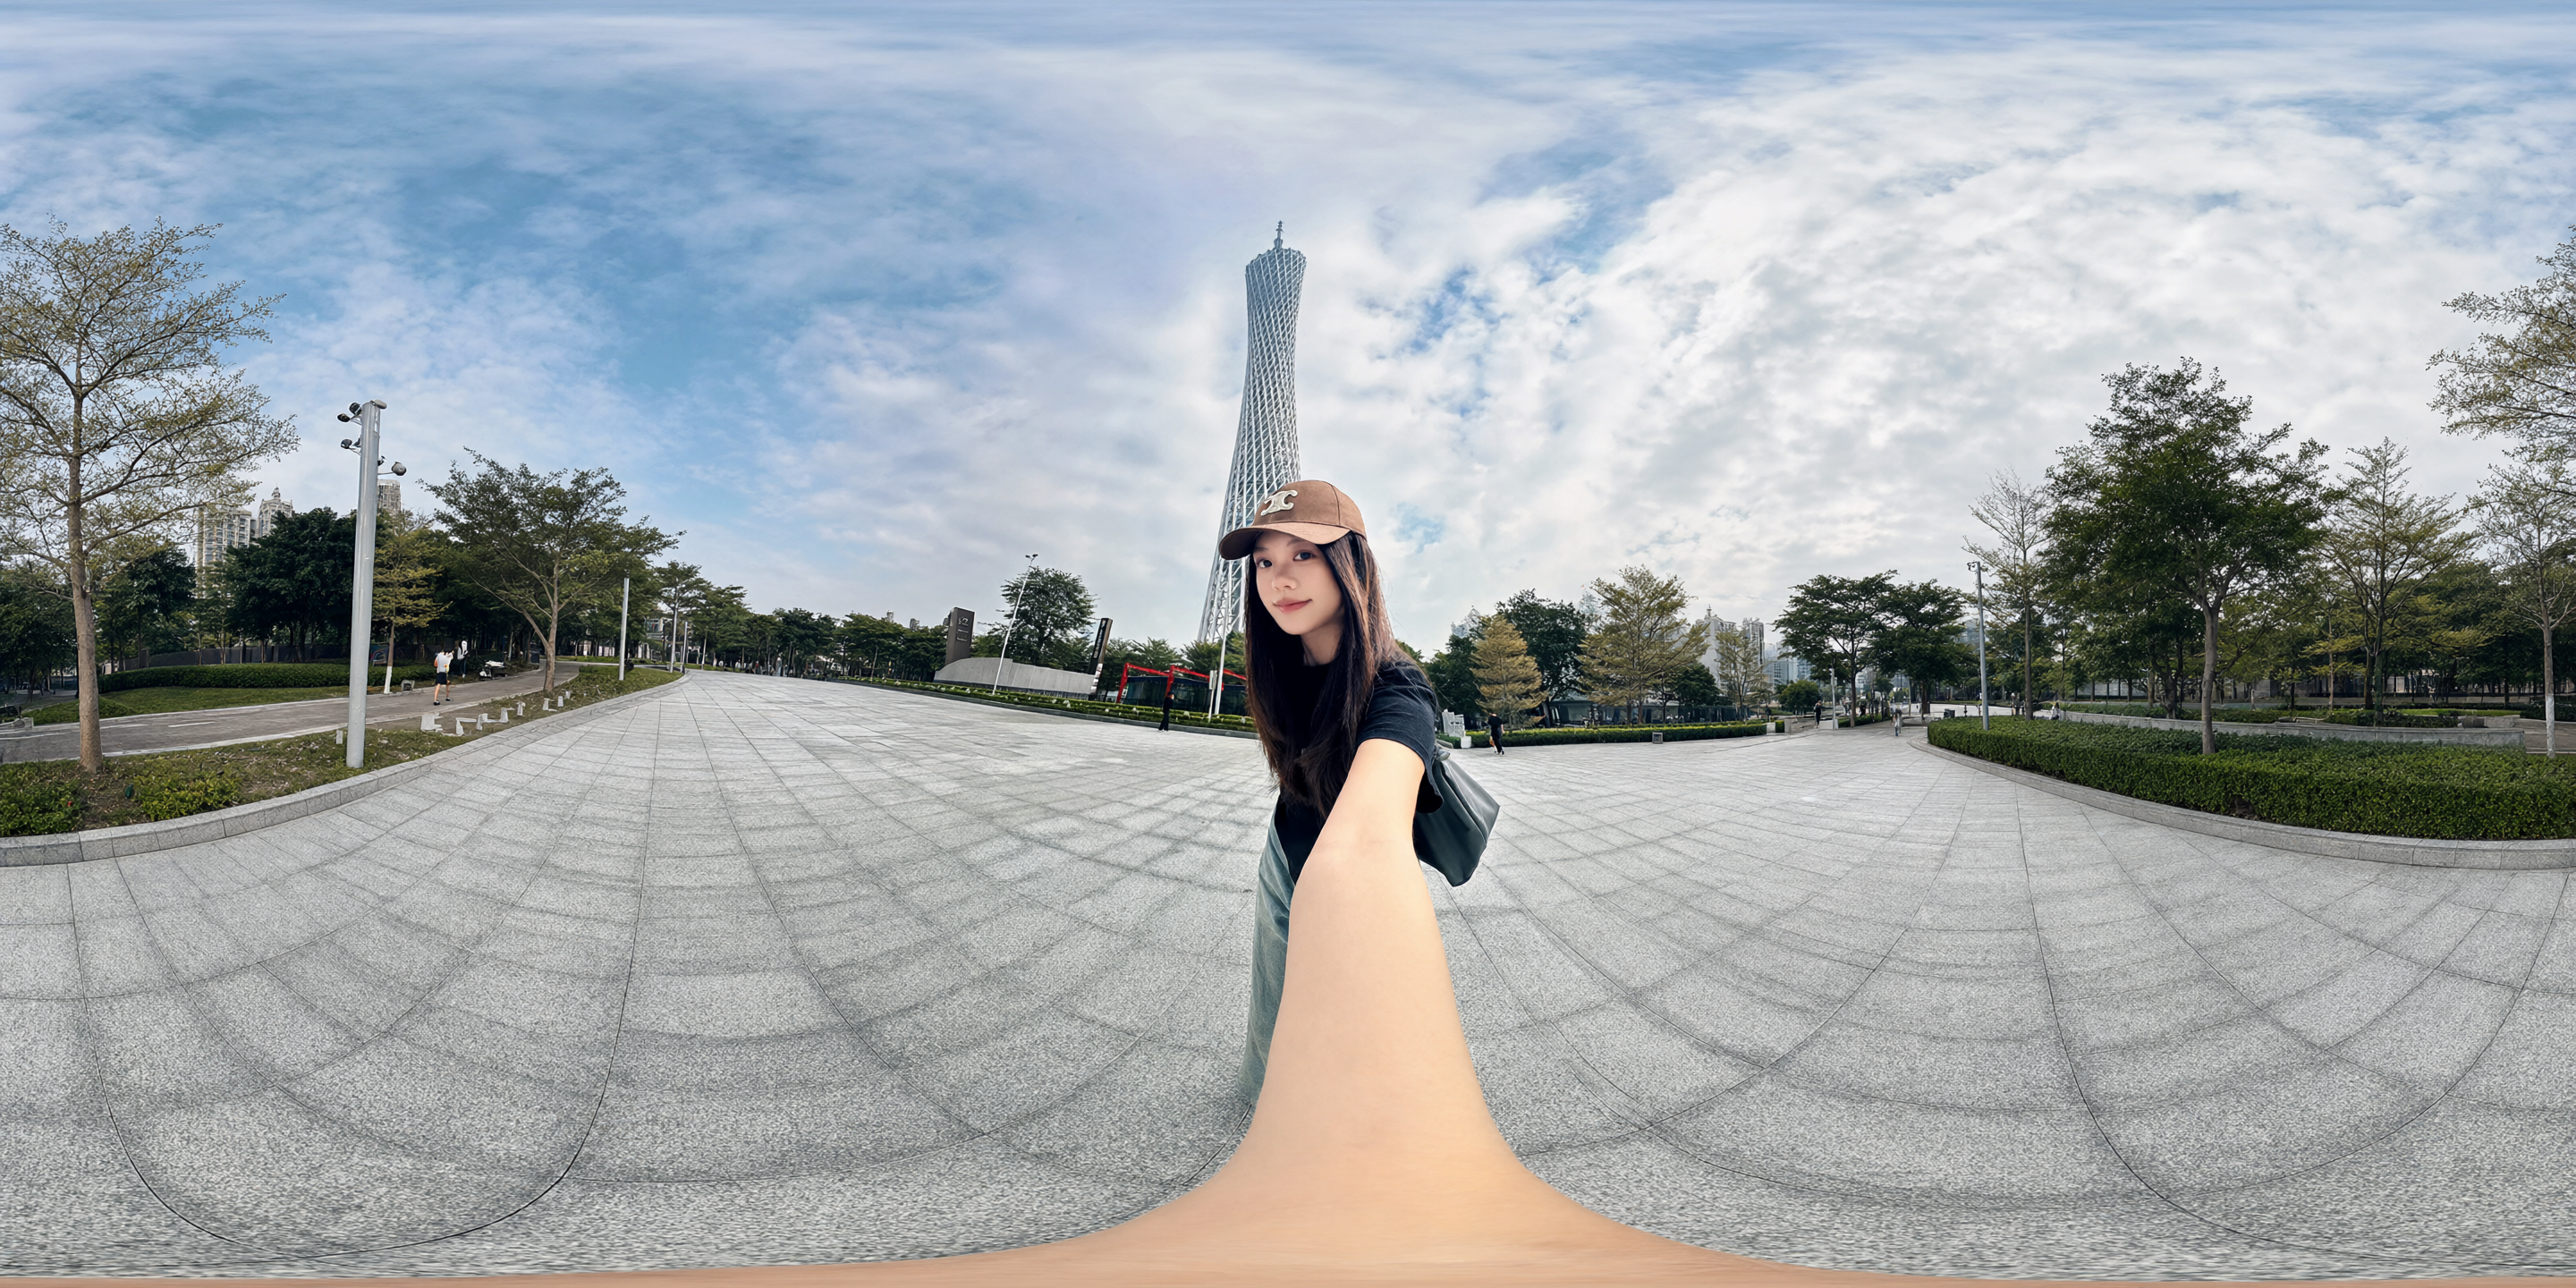
Пример 35: переход от селфи к виду от третьего лица. Тот же человек и место реконструированы в более широком кадре.
Листы персонажей и последовательность
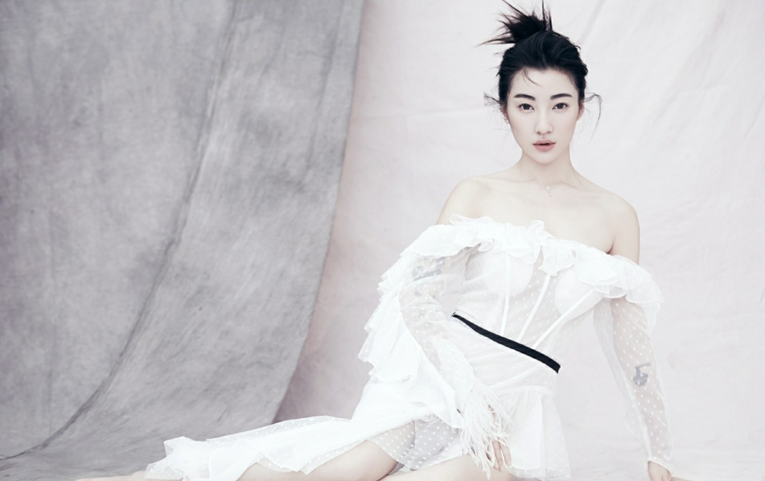
Пример 36: портрет человека в белой одежде. Вход для создания материалов персонажа.
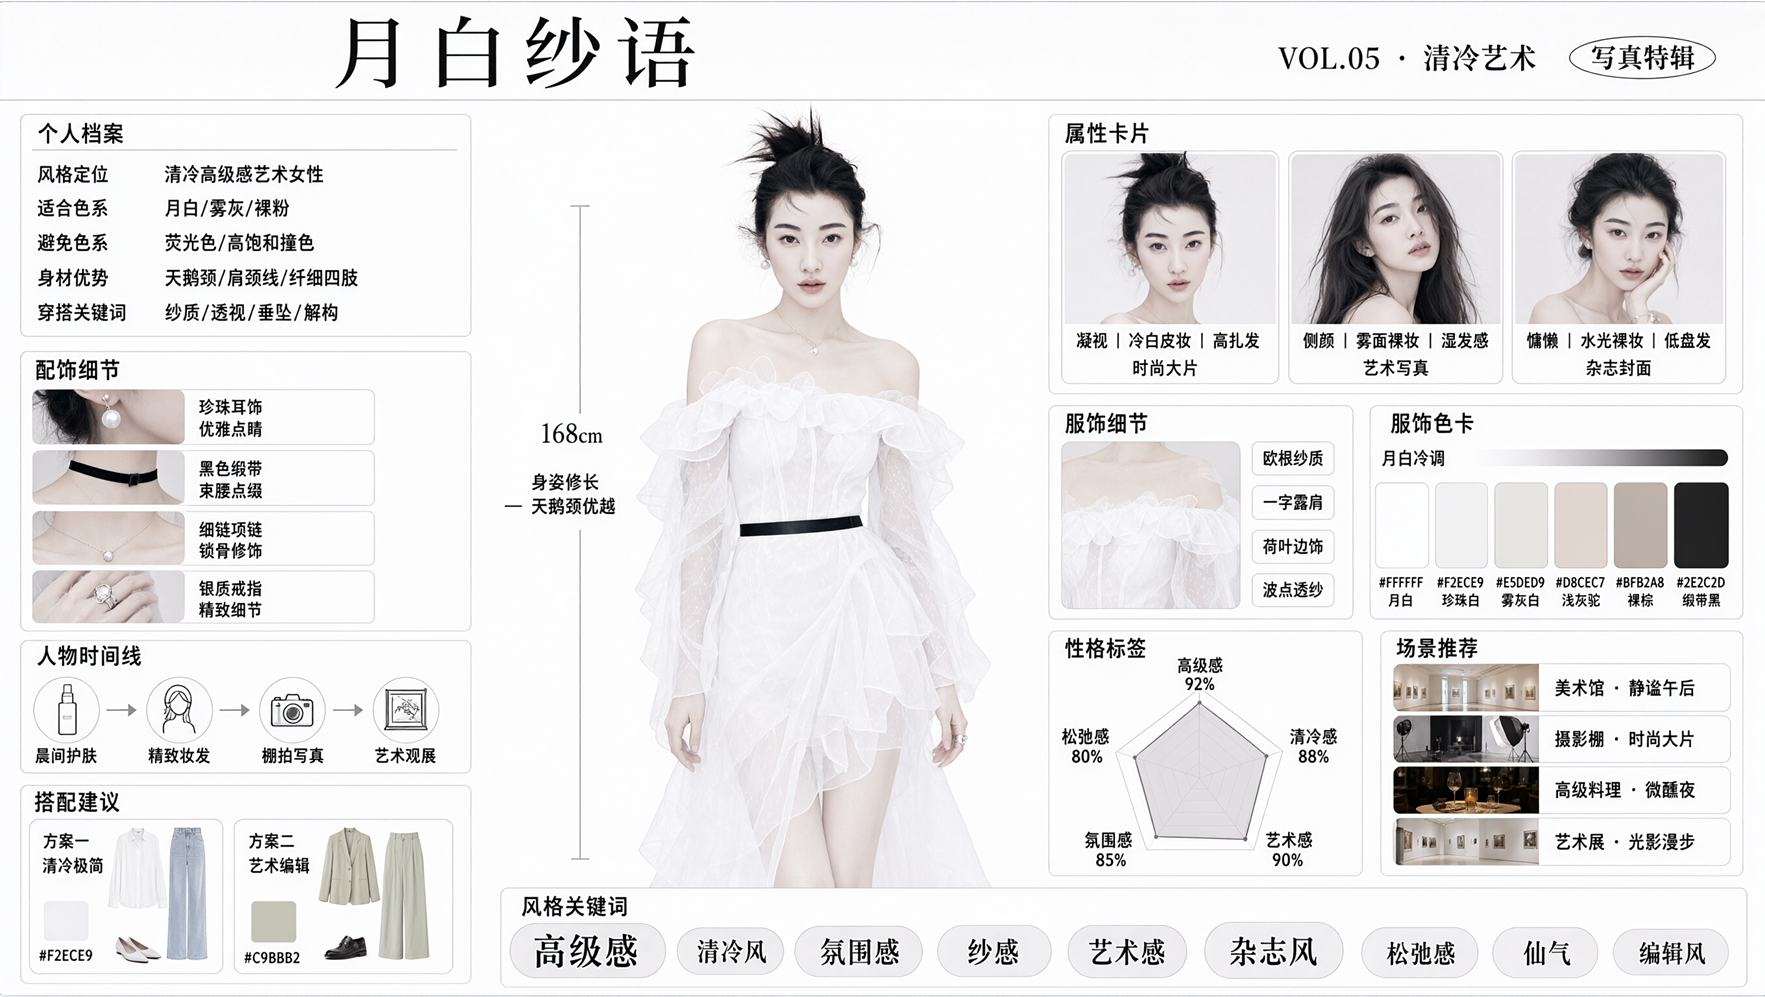
Пример 37: дизайн-лист персонажа в одном изображении. Объединены лицо, одежда, аксессуары и текстовая информация.
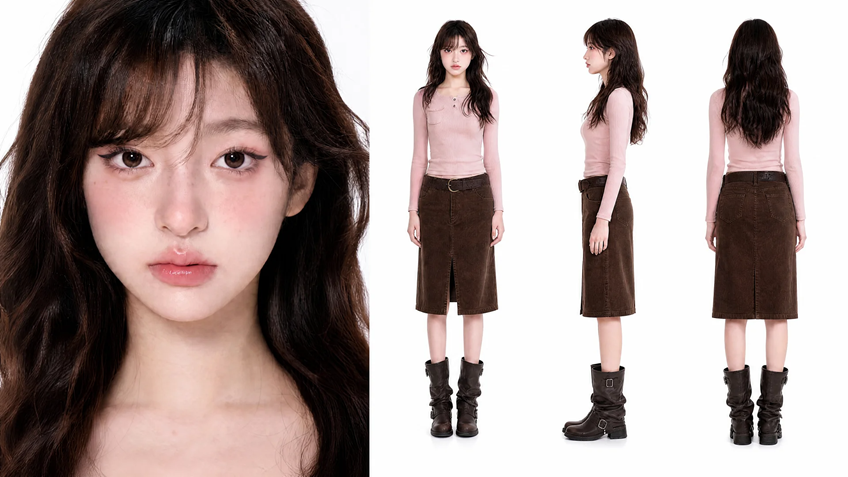
Пример 38: лист персонажа с видом спереди, сбоку и сзади. Для референсов в видео и комиксах.
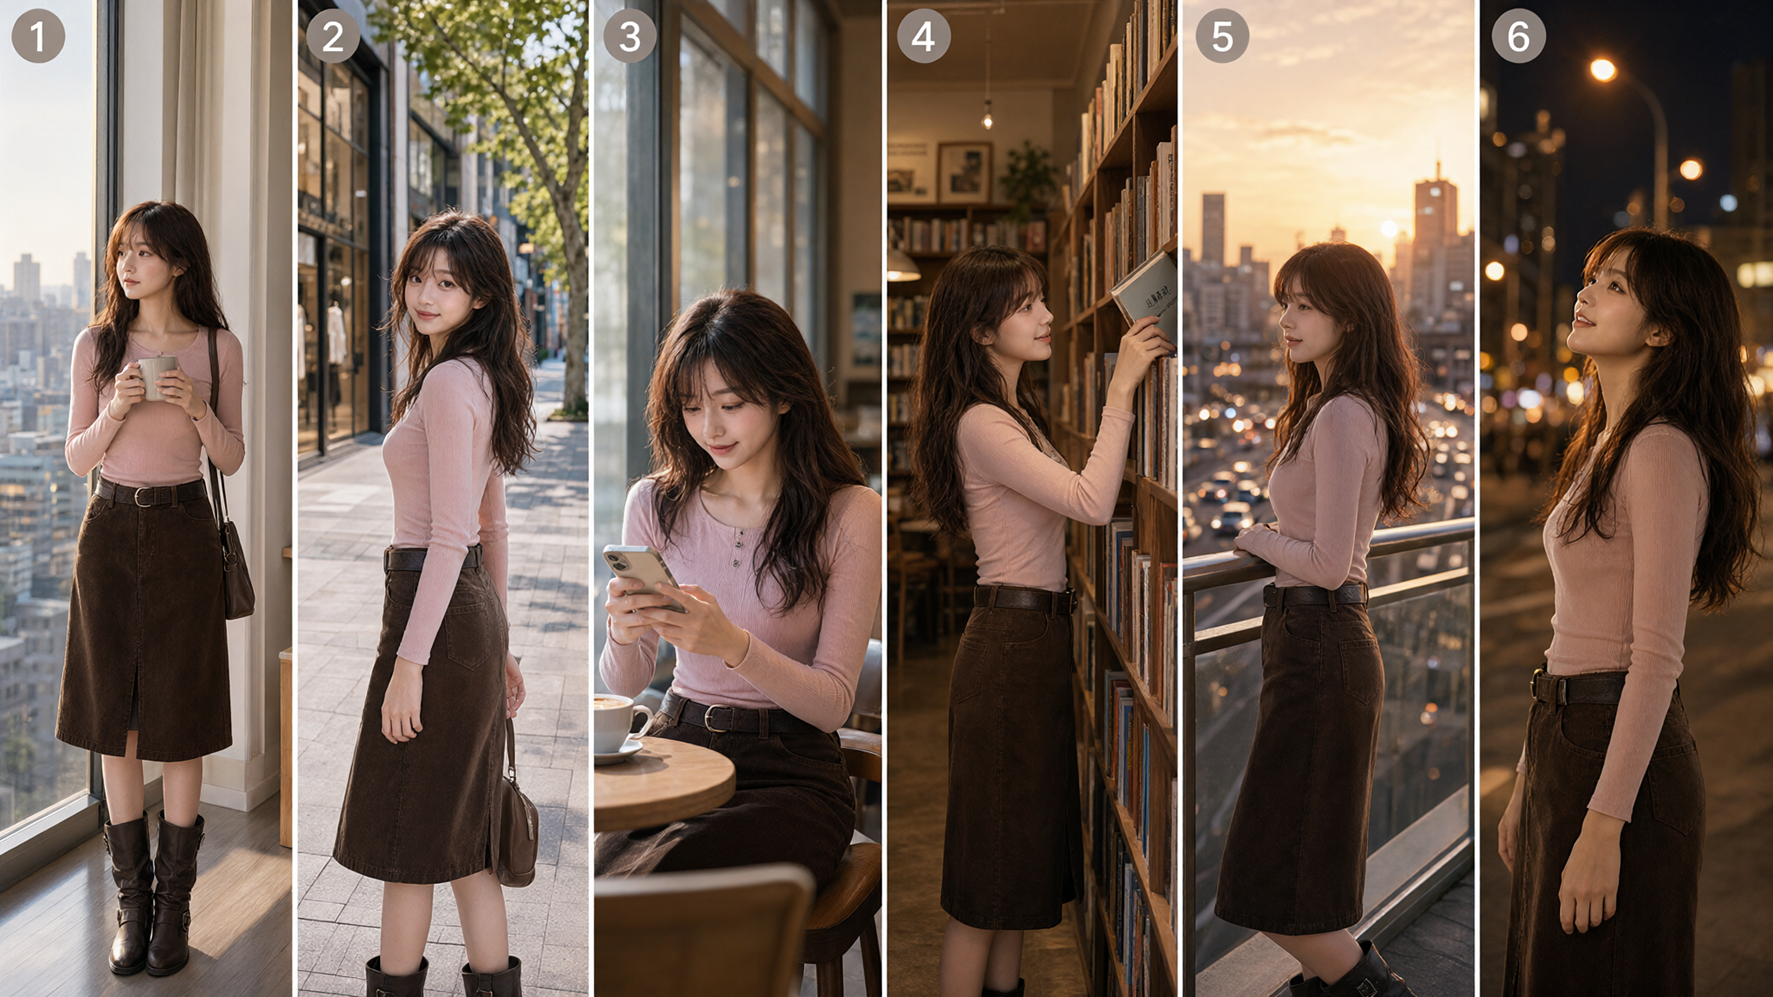
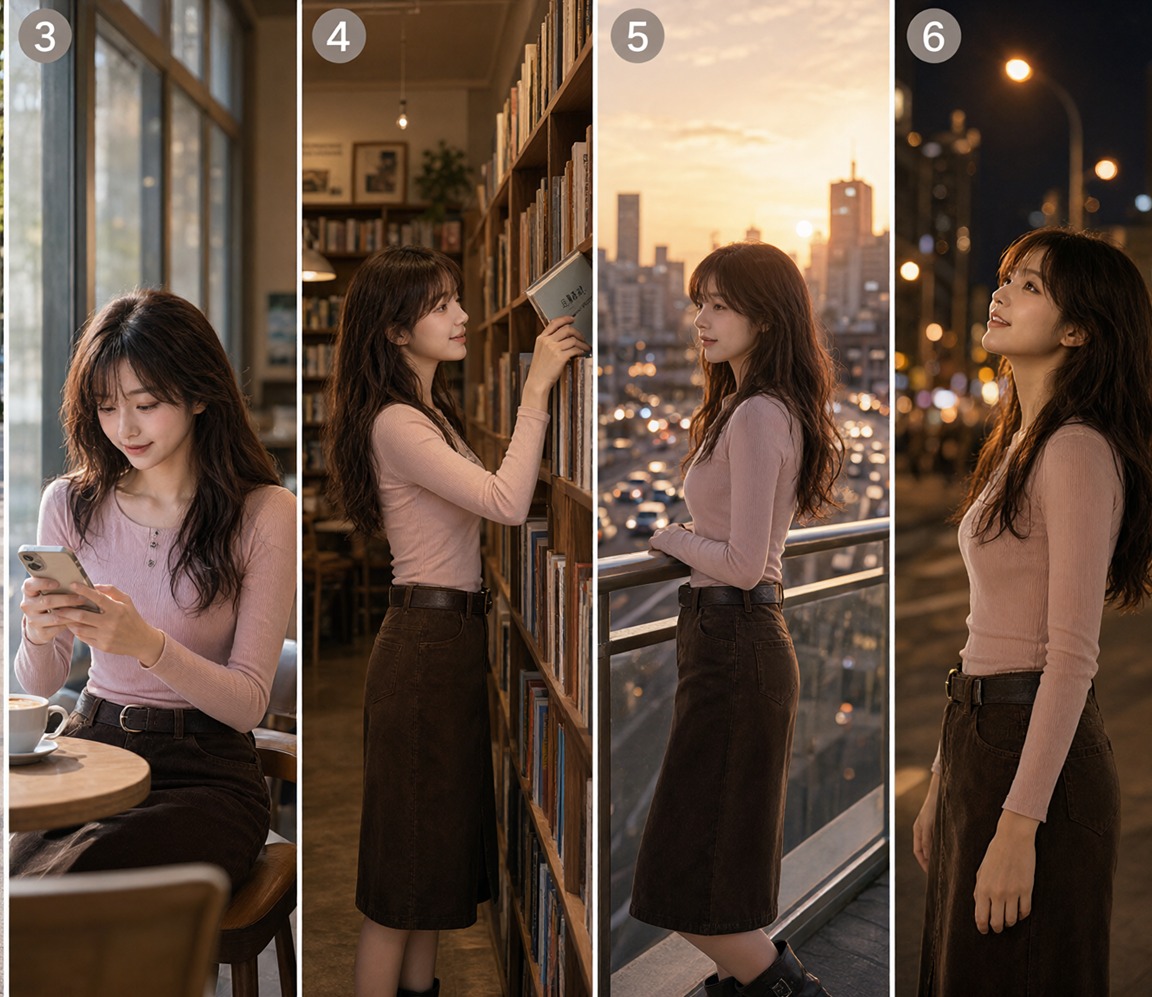
Пример 39: один человек в нескольких сценах. Проверка сохранения лица и одежды при изменении позы и места.
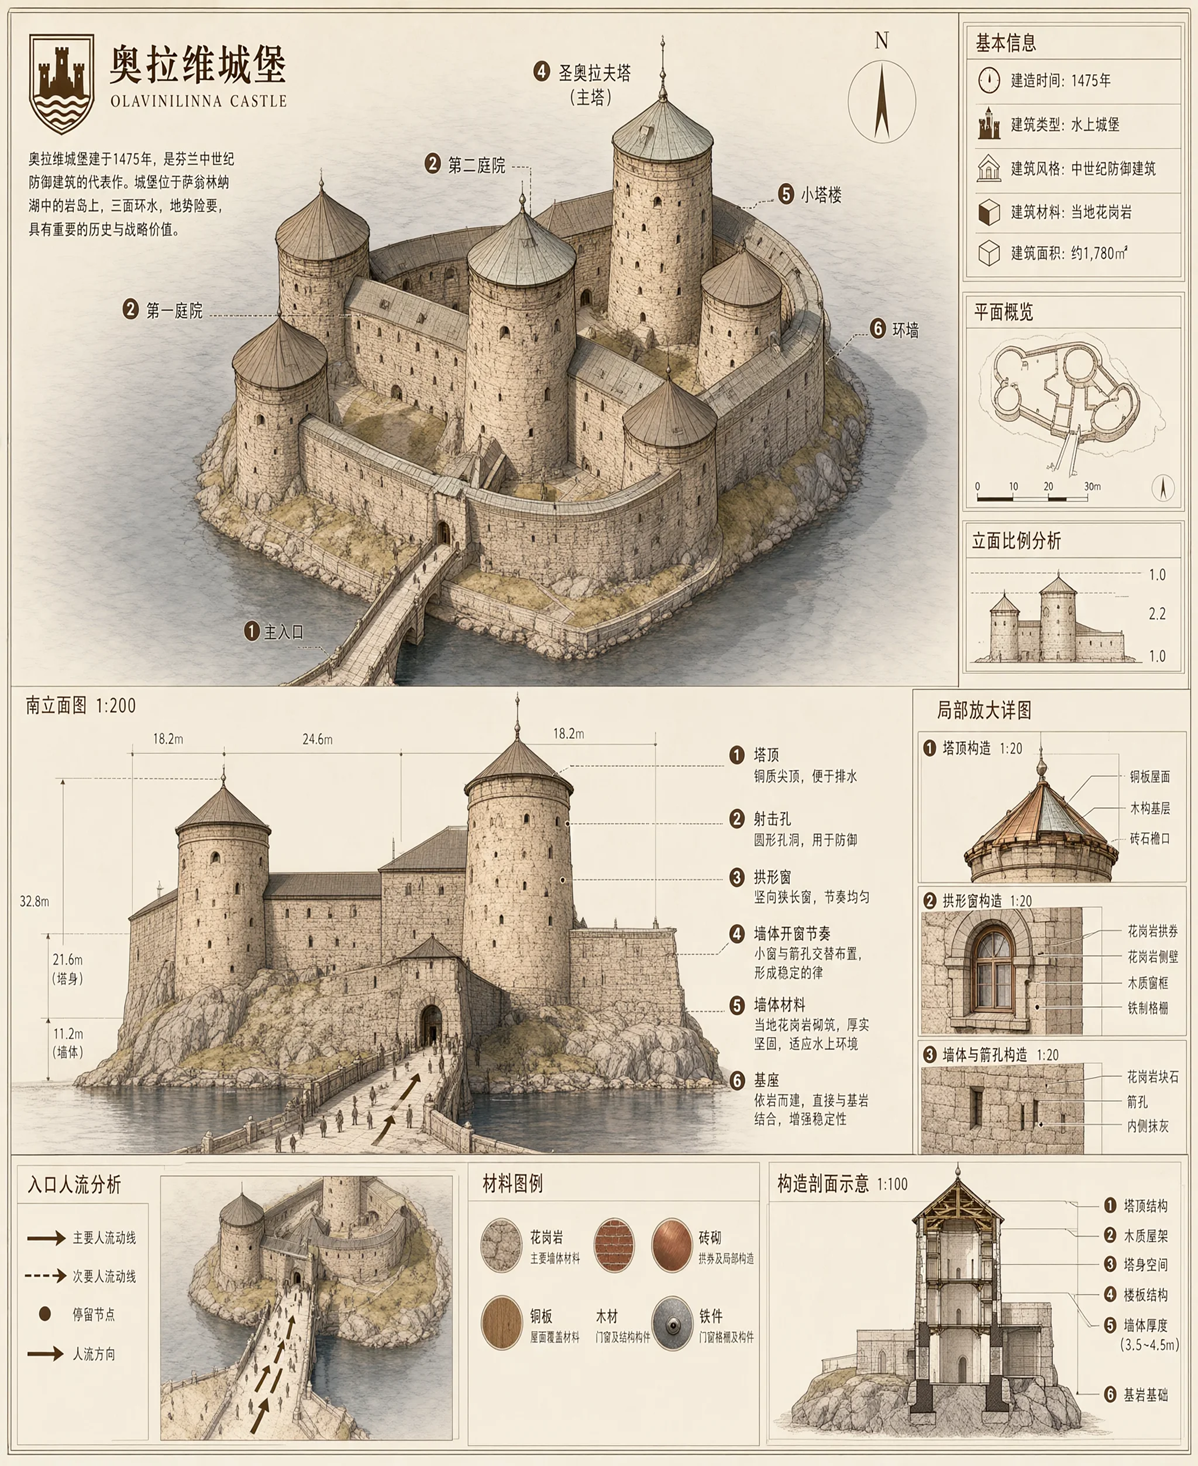
Пример 40: пояснительная схема здания. Генерация материала, объединяющего текст, чертежи, образцы материалов и аннотации.
UI, документы и естественные фотографии людей
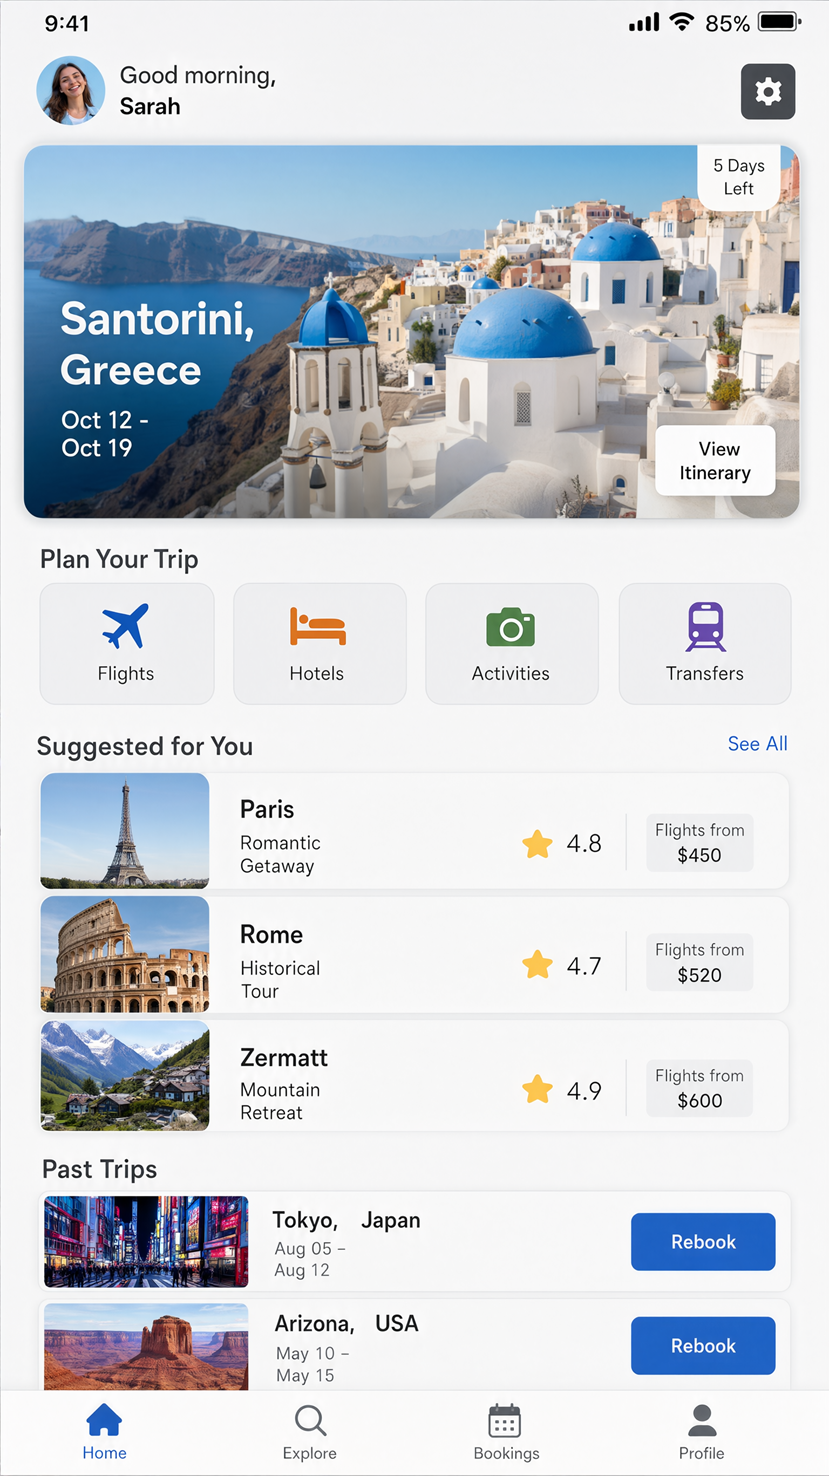
Пример 41: UI приложения бронирования путешествий. Дизайн экрана с мелким текстом, карточками, фотографиями и кнопками.
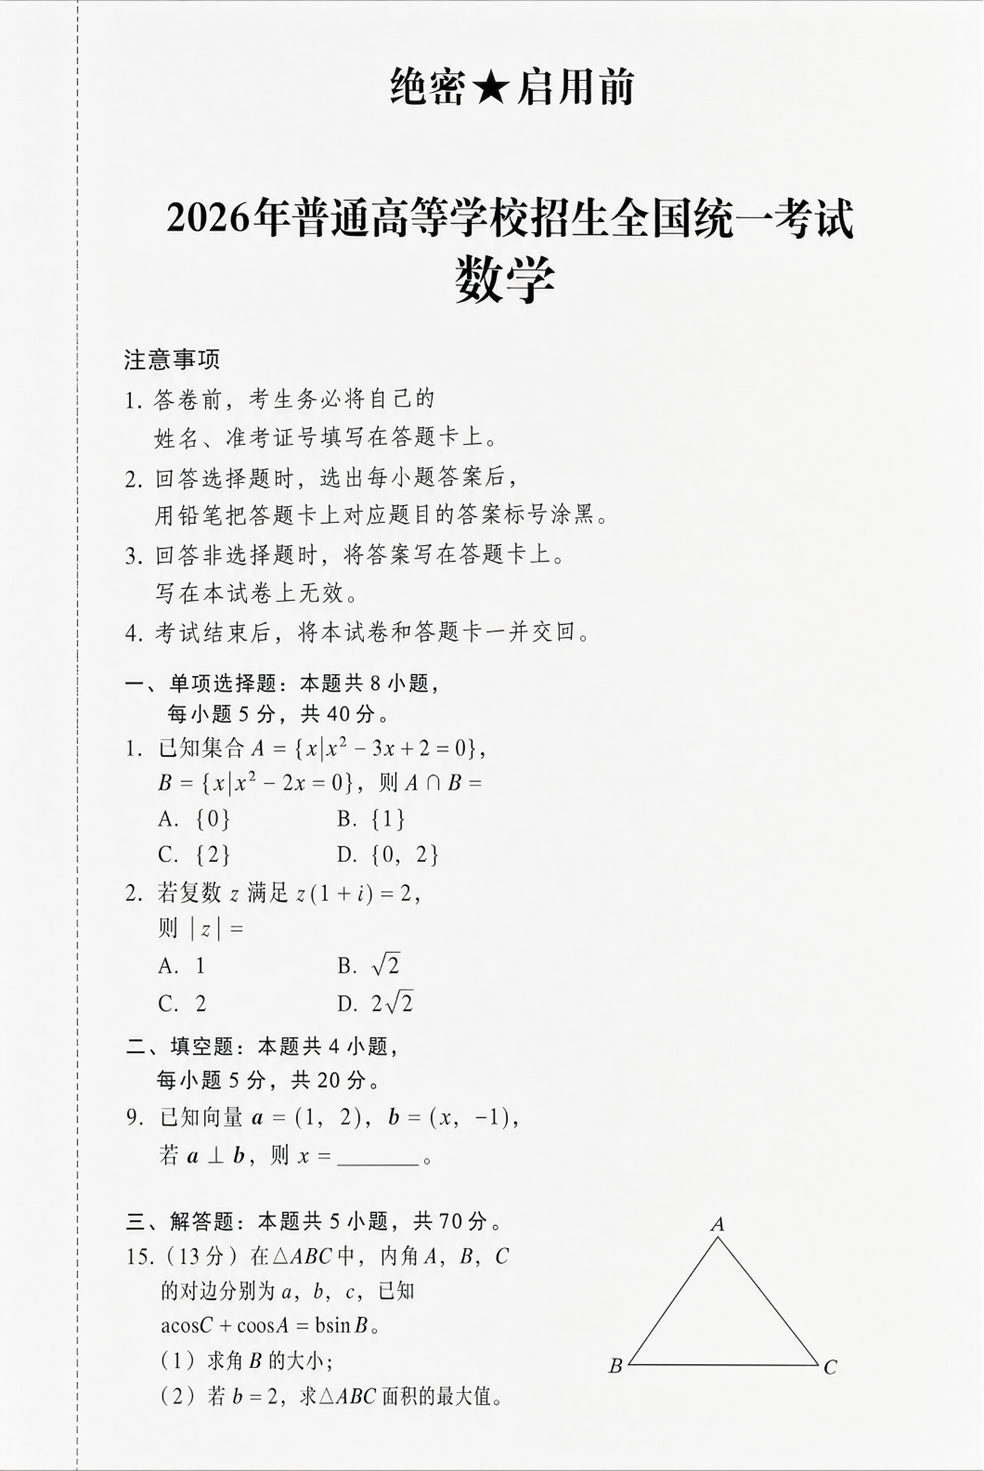
Пример 42: документ с геометрической задачей. Показывает сложность генерации страницы с длинным текстом и фигурами.
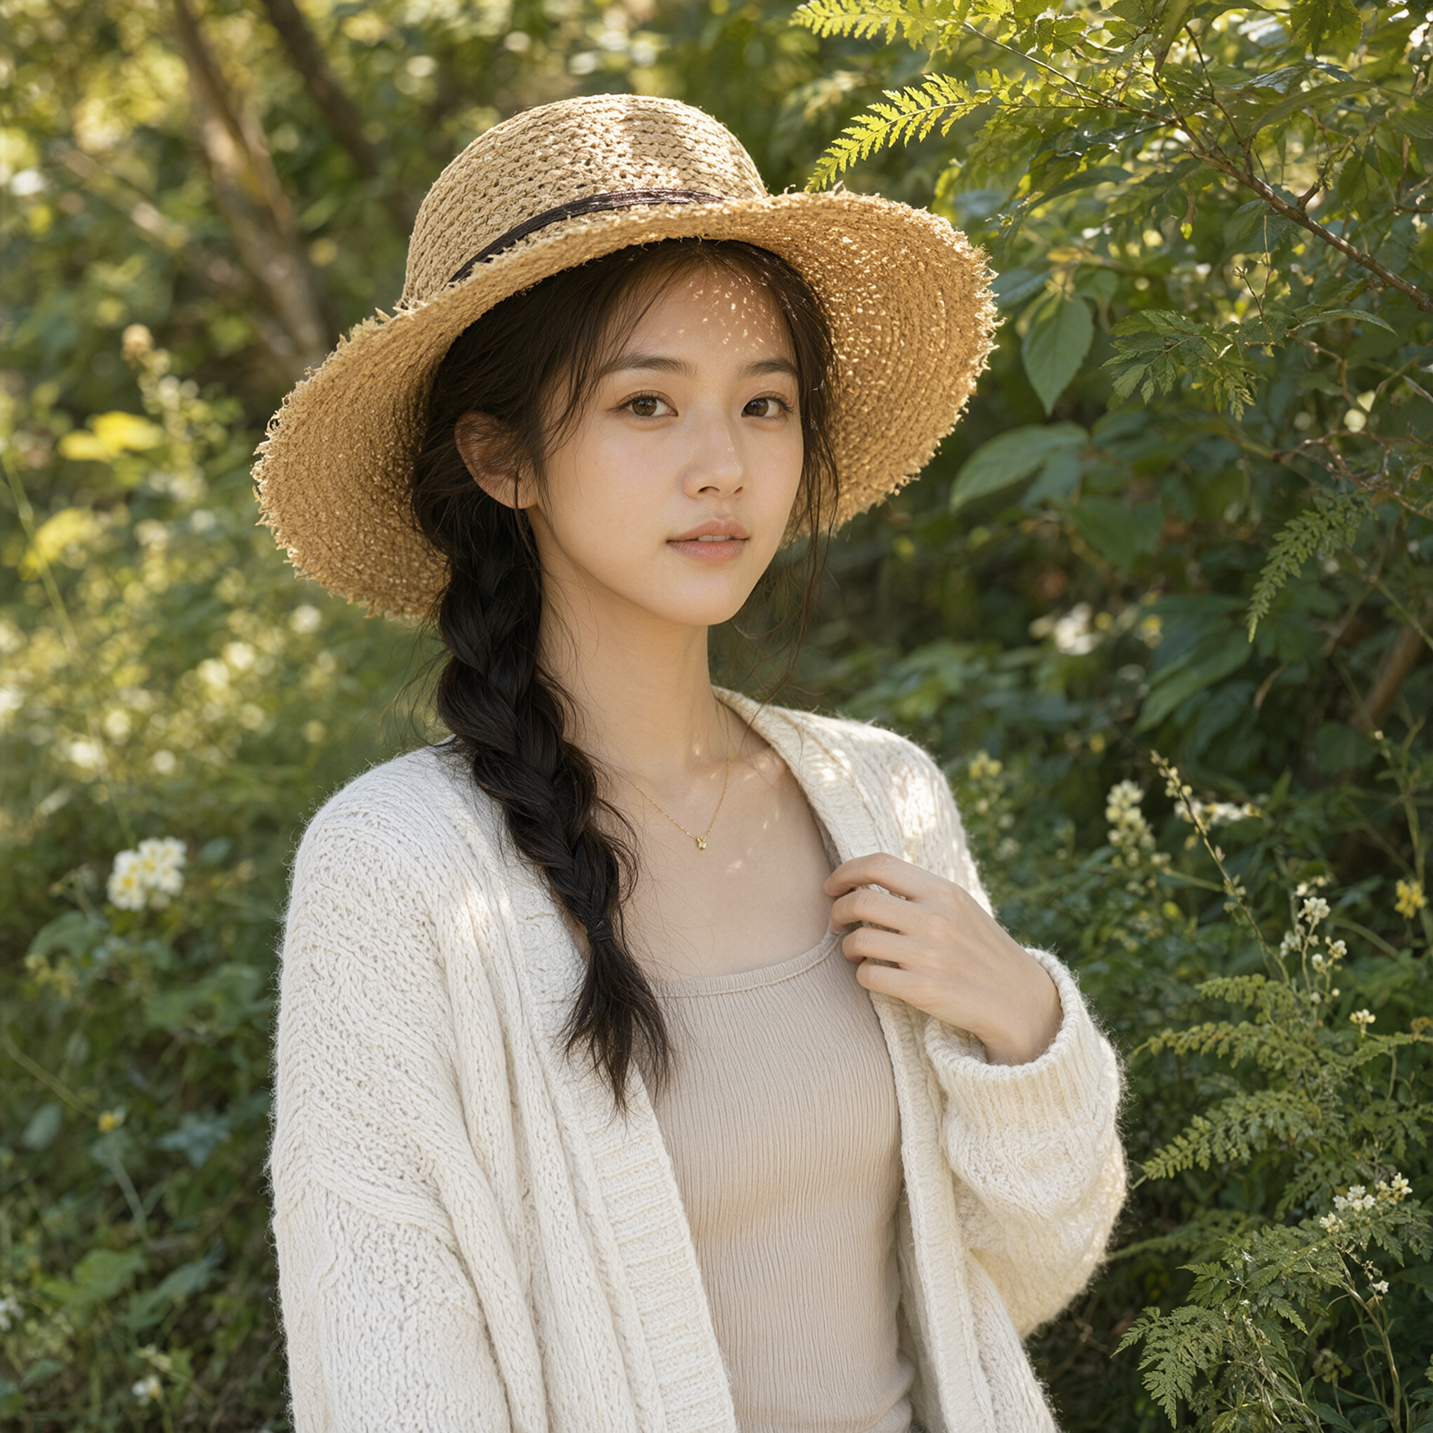
Пример 43: портрет при естественном уличном свете. Шляпа, волосы и пятна света сквозь листву.
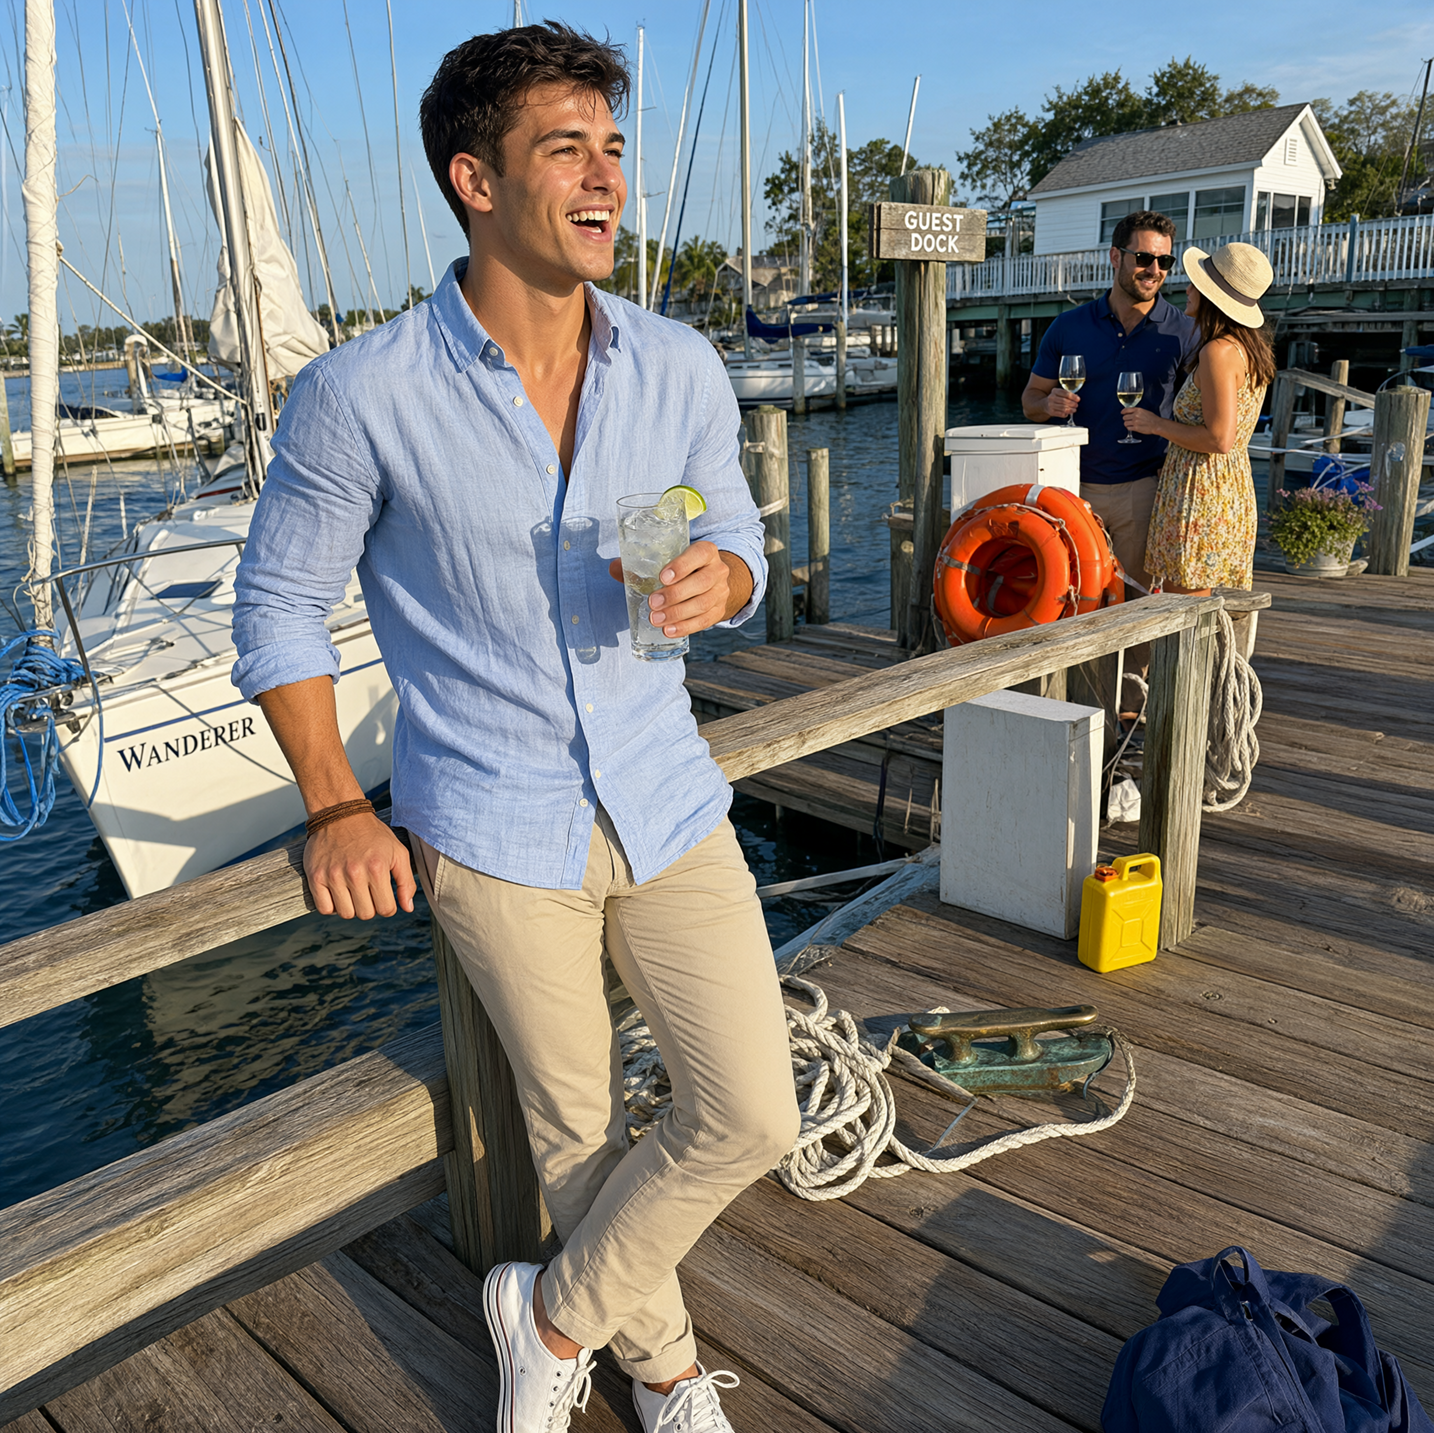
Пример 44: фотография человека на пристани. Фотореалистичный пример с детализированным фоном: верёвками, лодками и инструментами.
Увеличения и другие точки зрения для сравнения
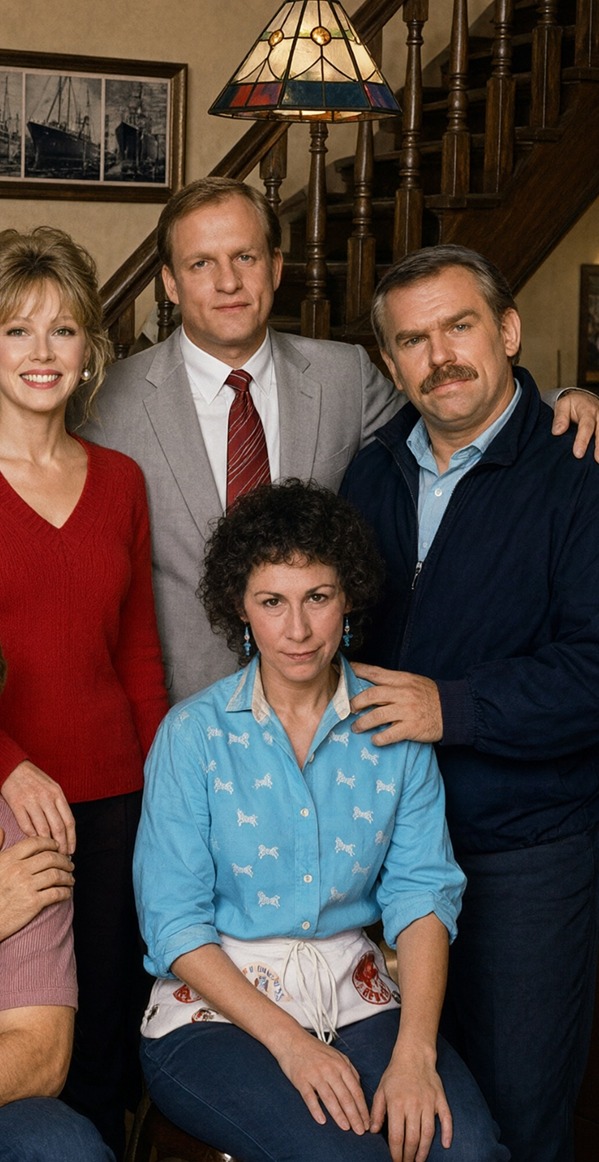
Пример 45: увеличенный фрагмент группового фото. Позволяет оценить лица, позы и освещение при объединении нескольких референсов в одно пространство.
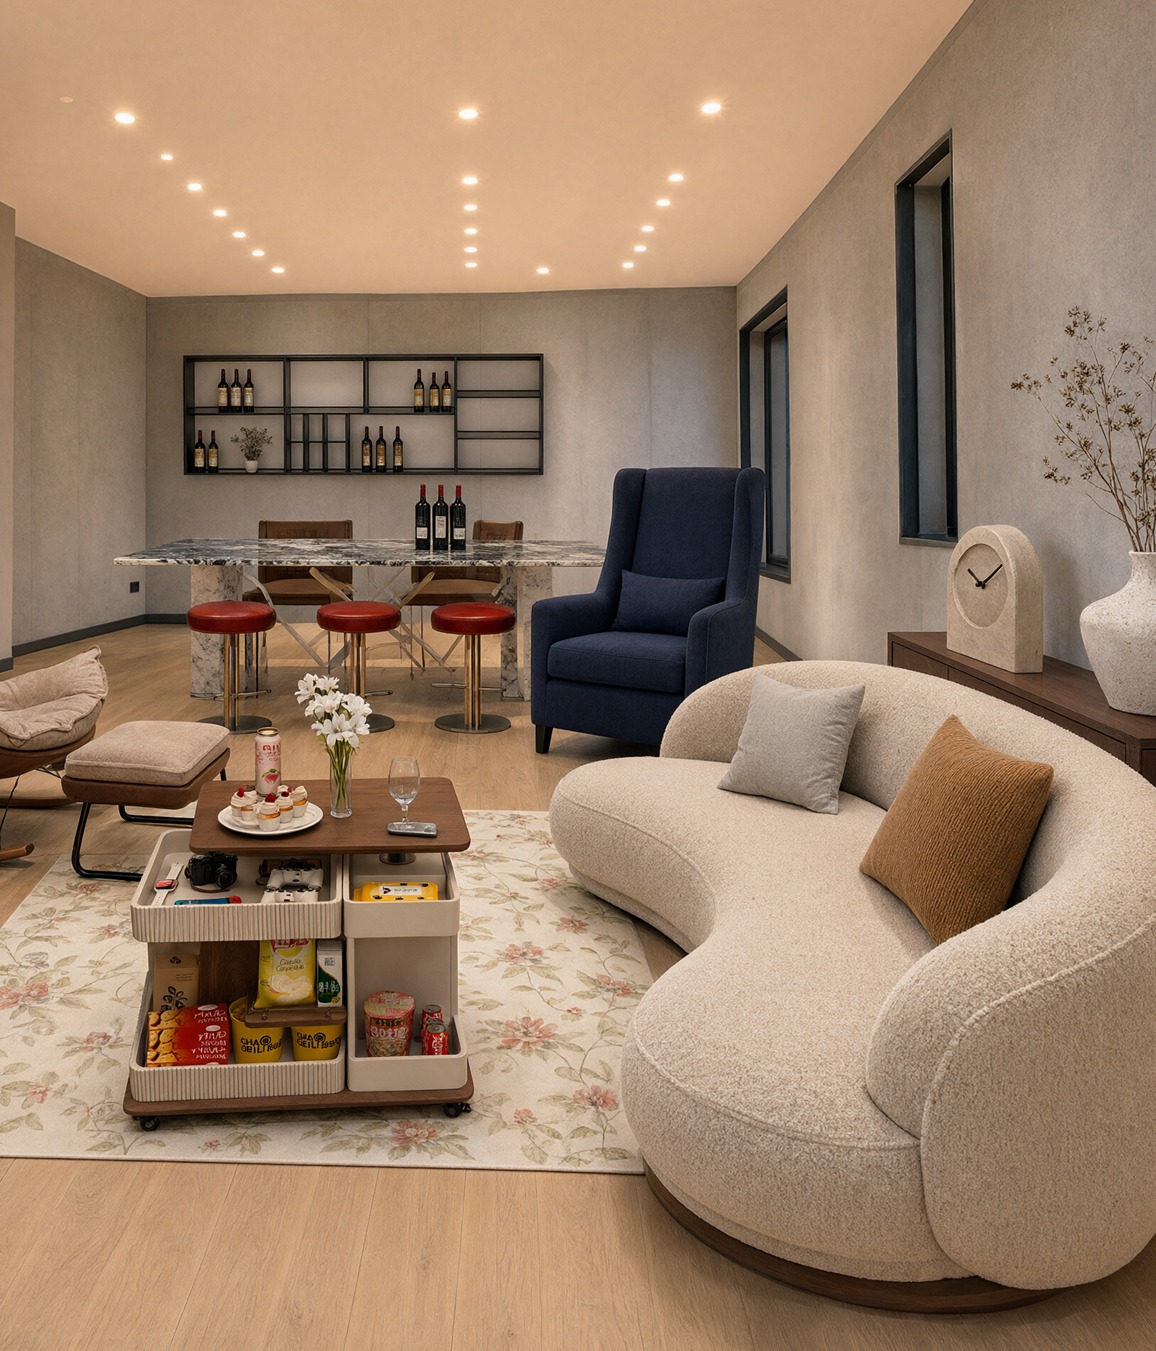
Пример 46: увеличенный интерьер после объединения мебели. Создание перспективы и света для всей комнаты по отдельным товарным референсам.
Пример 47: квадратный кроп после изменения точки камеры. Упрощает оценку соотношения масштаба башни и человека.
Пример 48: увеличение дизайн-листа персонажа. Видно локальное качество вариаций лица, текста и аксессуаров.
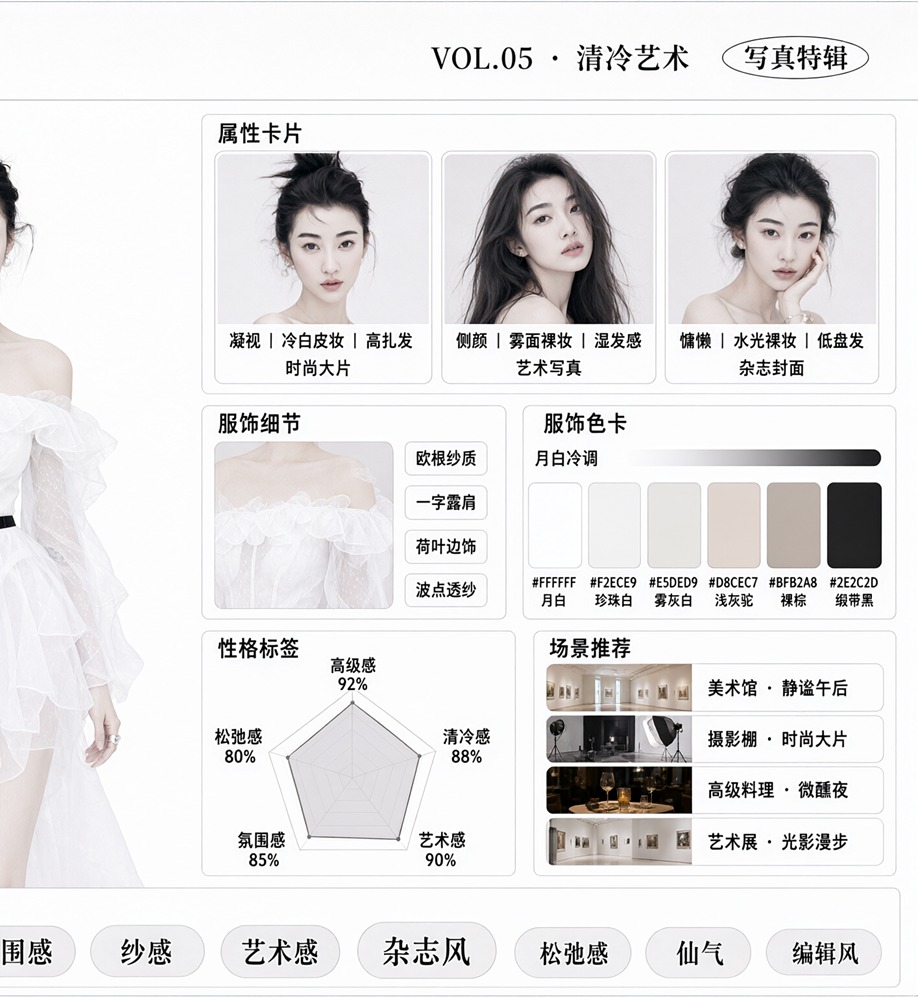
Пример 49: увеличенный фрагмент одного человека в нескольких сценах. Показывает важную для длинного производства согласованность одежды и лица.
Пример 50: увеличение архитектурной инфографики. Демонстрирует составную задачу из линейной графики, материалов, аннотаций и отступов.
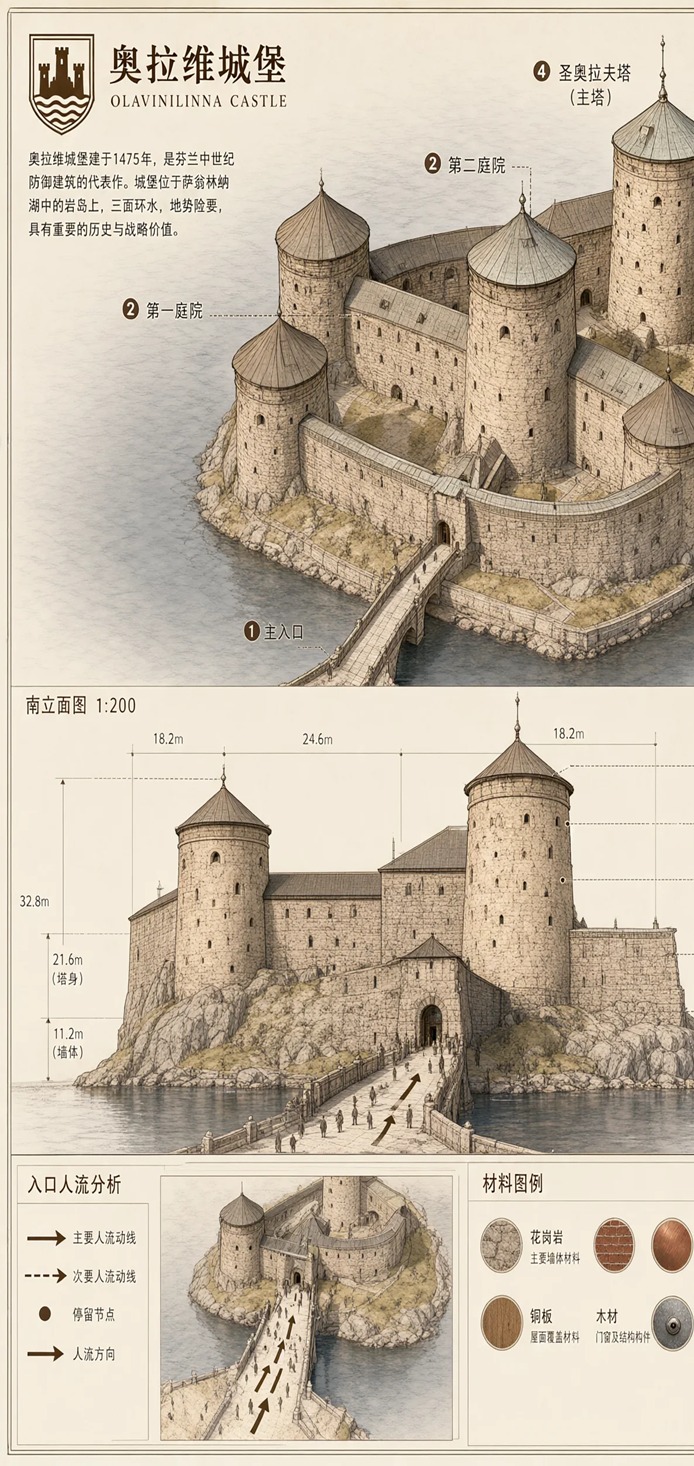
Источник изображений: официальные примеры Qwen Team «Qwen-Image-2.1». Шесть увеличений — отредактированные кропы для пояснительного сравнения.
100 популярных примеров и тестов с Reddit
Ниже 100 типов генерации и редактирования, действительно обсуждавшихся в основных публикациях Reddit о Qwen-Image 2.1. Поскольку в них отражены субъективные мнения авторов и различия окружений, это не бенчмарк, а практический каталог: что стоит протестировать, чтобы понять характер модели.
A. Фотографии людей и портреты (1–10)
- Любительская фотография женщины, будто снятая на смартфон.
- Повседневный портрет, снятый в торговом зале супермаркета.
- Портретная фотография с кинематографическим контровым светом.
- Пересветка человека на фоне ночного города.
- Одновременная смена погоды и времени суток на дождливую ночь.
- Фэшн-фотография с сохранённой текстурой кожи.
- Кадр в профиль справа с низкой точки камеры.
- Изменение камеры с фронтального фото на ракурс три четверти.
- Перегенерация лица с сильным изменением выражения.
- Создание «эталонного лица», объединённого из нескольких условий освещения.
Источники внимания: тест более чем 200 изображений 1girl (около 1 483 голосов), первый обзор
B. Согласованность персонажа (11–20)
- Лист одного персонажа спереди, сбоку и сзади.
- Материал персонажа с крупным планом лица и фигурой в полный рост.
- Создание одного согласованного лица из референса лиц 2×2.
- Перенос одного человека в другое место с сохранением лица.
- Смена только одежды у одного человека.
- Смена только причёски у одного человека.
- Замена только позы у одного человека.
- Отрисовка одного человека в реалистичной и комиксной версиях.
- Создание нескольких поз для последовательных кадров.
- Использование листа персонажа как референса для генерации видео.
Источники внимания: дизайн-лист персонажа, референс лица в четырёх ракурсах (около 157 голосов), Qwen против FLUX.2 Krea (около 116 голосов)
C. Перенос позы, камеры и композиции (21–30)
- Перенос позы с человека на референсе 2 на человека на референсе 1.
- Размещение сидящего человека на жёлтом кресле с другого изображения.
- Перевод стоящей позы в сидячую с сохранением одежды.
- Смена фронтальной композиции на средний план с низкого ракурса.
- Расширение кадра без изменения масштаба объекта.
- Перенос позы со студийного изображения позы на реалистичного человека.
- Превращение реалистичного человека в стиль «Симпсонов» с сохранением позы.
- Сохранение положения товара при изменении угла камеры.
- Применение глубокой резкости и к переднему, и к заднему плану.
- Создание группового фото без нарушения расположения нескольких людей.
Источники внимания: советы по редактированию (около 513 голосов), Editing Beast (около 840 голосов)
D. Товары, реклама и виртуальная примерка (31–40)
- Массовая замена смятой банки Coca-Cola на банку другого товара.
- Изменение только цвета и дизайна с сохранением деформации банки.
- Отражение цвета товара на окружающих белых поверхностях.
- Естественное размещение часов с другого изображения на запястье человека.
- Реклама часов с сохранением исходной позы, телосложения и освещения.
- Примерка по пяти референсам: модель, одежда, обувь, сумка и шляпа.
- Размещение логотипа с другого изображения на товарной фотографии.
- Замена только упаковки с сохранением съёмочной сцены.
- Вырезание товара на прозрачный фон для e-commerce.
- Развёртывание одного товара на нескольких фонах и при разном освещении.
Источники внимания: Editing Beast (около 840 голосов), примеры с несколькими референсами в официальном блоге
E. Редактирование фона, освещения и материалов (41–50)
- Смена дневного фона на дождливую ночь.
- Замена только фона с сохранением человека.
- Одновременный перенос освещения и фона с референсного изображения.
- Замена поверхности стены на зелёную текстуру с другого изображения.
- Изменение интерьера на тёплое вечернее освещение.
- Смена на резкое освещение в стиле high-fashion съёмки.
- Пересчёт тени человека под фоновое освещение.
- Сравнение фотореализма обычного шума и Brownian noise.
- Сравнение текстур при сэмплерах Euler и custom eta 0.50.
- Сочетание резкости и естественности с двухэтапным сэмплером.
Источники внимания: советы по редактированию, ветка проверки настроек (около 80 голосов)
F. Прозрачные PNG, вырезание и локальное редактирование (51–60)
- PNG одного персонажа на прозрачном фоне.
- Прозрачный товарный ассет.
- Прозрачный дизайн-ассет из нескольких элементов.
- Извлечение только человека из фотографии.
- Редактирование объекта на прозрачном слое.
- Инпейтинг формы с границей альфа-канала.
- Одновременное изменение формы наушников и прозрачной области.
- Замена только области одежды, закрашенной красным.
- Редактирование только аксессуара, обведённого кругом.
- Локальное редактирование с полным возвратом области вне маски.
Источники внимания: альфа-редактирование в LanPaint (около 77 голосов), первый обзор
G. Аутпейнтинг и восстановление (61–70)
- Расширение холста только слева.
- Расширение холста только справа.
- Расширение холста только сверху.
- Расширение холста только снизу.
- Одновременное расширение слева, справа и снизу.
- Заполнение пустот на наклонённой фотографии.
- Восстановление фона, утраченного из-за плохого кропа.
- Дорисовка окружения частично обрезанного объекта.
- Превращение в широкий кадр с сохранением исходного фона.
- Сравнение изменений зернистости и контраста при реставрации старого фото.
Источники внимания: тест аутпейнтинга (около 62 голосов), критическое тестирование реставрации фотографий
H. Постеры, текст и графический дизайн (71–80)
- Постер мероприятия с крупным заголовком.
- Рекламный дизайн с заранее определёнными композицией и информационной иерархией.
- Сравнение стабильности крупного текста при 2–2,5 MP.
- Сравнение детализации визуала без текста при примерно 4 MP.
- Дизайн упаковки с названием товара.
- Графика с надписью «Qwen» на винтажном телевизоре.
- Естественный композитинг вывесок и логотипов из другого изображения.
- Сложный макет по длинному промпту.
- Тест искажения текста и примеси китайского в англоязычной инфографике.
- Постер, сравнивающий качество дизайна с GPT-подобными моделями изображений.
Источники внимания: шаблон промпта для дизайна, краткий обзор и пример с винтажным ТВ
I. Стилизация, иллюстрация и создание историй (81–90)
- Преобразование реалистичного фото в комиксный стиль.
- Преобразование реалистичного человека в стиль «Симпсонов».
- Перенос только художественного стиля референса на другое изображение.
- Изменение цветового тона с сохранением персонажа и фона.
- Генерация изображения в стиле Polaroid.
- Генерация раскадровки в формате четырёх кадров.
- Развёртывание одного человека в нескольких сценах.
- Последовательные сюжетные кадры с сохранением животных, машин и людей.
- Иллюстрация в стиле скриншота современного аниме.
- Сравнение неудач аниме-стиля, который тянет к реализму.
Источники внимания: эксперимент с Polaroid, сравнение с Krea 2 для аниме-задач, первый обзор
J. Workflow, скорость и сравнение качества (91–100)
- Сравнение композиции, фактуры и контраста при CFG 1–5.
- Сравнение «пережаренного» результата при CFG ниже 2 и CFG 4.
- Быстрая генерация на 16 шагах, 1 MP и INT8.
- Проверка качества редактирования на 25 шагах и 2K.
- Апскейл с 2K до 4K после 30 шагов.
- Редактирование с расчётом на примерно двукратное ускорение через 4-step LoRA.
- Генерация человека за около 45 секунд: 8 шагов, 1024×1280, RTX 3060.
- Сравнение скорости Qwen и FLUX.2 Krea для листов персонажей.
- Тест пиксельной точности на 2K и объединения 10 референсных изображений.
- Сравнение Fix v2.0 и специализированного сэмплера для снижения шума мелких деталей.
Источники внимания: ветка выпуска моделей для ComfyUI (около 106 голосов), 4-step при малом VRAM (около 44 голосов), результаты экспериментов, Fix v2.0
Кратко об оценках Reddit
Что особенно высоко оценивают
- Качество редактирования: модель сравнительно хорошо сохраняет исходное изображение при изменении цветов, фона, материалов, позы и товара.
- Несколько референсов: сильна в задачах, где нужно сочетать людей, товары, одежду и аксессуары.
- Согласованность персонажа: перспективна как начальная точка для материалов персонажа и последовательных кадров.
- Прозрачные изображения: может не только вырезать объект, но и генерировать и редактировать сам альфа-канал.
- Аутпейнтинг: удобна для одновременного расширения в нескольких направлениях.
- Размер и скорость: для генеративной части на 7B практична и имеет много вариантов квантизации и ускорения.
Часто отмечаемые слабости
- Нестабильны кисти, пальцы, руки и сложная анатомия.
- Лица на дальнем плане и тонкие линии легко распадаются.
- В стандартном выводе иногда присутствуют шум и дефекты мелких деталей.
- Контраст может быть слишком сильным, а чёрный — чрезмерно проваливаться.
- При реставрации фото модель может самовольно менять исходную зернистость и мелкие формы.
- Есть критика коренастых пропорций в листах персонажей.
- При большом числе референсов чаще возникают смешение атрибутов и галлюцинации.
- Некоторые аниме-стили тянет в сторону реализма и киношной картинки.
- Текст иногда получается сильным, но мелкий текст и англоязычные инфографики нестабильны.
- Результат сильно зависит от настроек, prompt rewriting и сэмплера.
Из этих плюсов и минусов видно, что Qwen-Image 2.1 — не «идеальная универсальная модель за один запуск», а производственная модель, которая особенно раскрывается при настройке параметров и workflow вокруг редактирования.
Практический старт
В ComfyUI обновитесь до актуальной версии и выберите встроенный шаблон Text-to-Image либо Image Edit. Официальные поддерживаемые workflow также опубликованы на GitHub. Сначала полезно создать эталонное изображение на близких к официальным 40 шагах, затем снизить число шагов до 16, 8 и 4, сравнивая скорость и качество.
При редактировании вместо расплывчатого «сделай лучше» удобнее формулировать запрос в таком порядке:
- Что изменить.
- Из какого референсного изображения это взять.
- Что категорически нельзя менять.
- Как сохранить свет, фон, телосложение, позу и композицию.
- Какие склонные к ошибкам элементы включить в негативную инструкцию.
Например, для композитинга товара: «Сохрани человека и позу с изображения 1, надень только часы с изображения 2 на запястье. Не меняй телосложение, фон и освещение». В задаче с несколькими референсами важно не делать соответствия <image1> и <image2> неоднозначными.
Для прозрачных изображений в примерах Reddit явно используются формулировки «RGBA image», «alpha channel» и «background is transparent». Если нужно редактировать саму прозрачную границу, применяйте масочную обработку с поддержкой альфа-канала, например LanPaint.
Кому подойдёт
Qwen-Image 2.1 хорошо подходит для следующих задач.
- Тем, кто хочет работать локально в ComfyUI.
- Тем, кому нужно менять только отдельные части человека или товара.
- Тем, кто хочет объединять несколько референсных материалов в одну рекламу или сцену.
- Тем, кто создаёт материалы персонажей или референсные изображения для видео.
- Тем, кому нужны прозрачные PNG и ассеты для игр или веба.
- Исследовательским и разработческим командам, эксплуатирующим API генерации и редактирования изображений на собственных серверах.
Напротив, для точной реставрации фотографий, строгой идентичности в длинных последовательных работах, сложных поз с критичными кистями рук, инфографики с плотным мелким текстом и безусловного внедрения под коммерческое использование необходимо сравнение с другими моделями и проверка лицензии.
Итоги
Суть Qwen-Image 2.1 — в объединении T2I, редактирования изображений, до 10 референсов, локального редактирования, прозрачного RGBA и извлечения объектов в сравнительно компактной генеративной части на 7 млрд параметров. Наибольший интерес Reddit вызывает не простая генерация красивых девушек, а сокращающие производственный путь задачи: замена часов и банок, листы персонажей, перенос фона и освещения, аутпейнтинг и альфа-редактирование.
В то же время оценка примеров сильно зависит от настроек. CFG, сэмплер, число шагов, разрешение, prompt rewriting и ускоряющие LoRA способны изменить результат настолько, что он кажется работой другой модели. Безопасный подход — сначала получить базовый результат на официальных настройках, затем менять по одному параметру и для важных задач проводить слепое сравнение с другими моделями.
И главное предостережение — лицензия. Публикация весов не означает, что коммерческое использование автоматически свободно. Технически модель очень привлекательна, но для внедрения в рабочие процессы решение стоит принимать только после проверки официальной лицензии и актуальных условий.
Основные ссылки
- Официальный блог Qwen-Image 2.1
- Официальный репозиторий GitHub
- Документация Hugging Face Diffusers
- Модель для ComfyUI
- Reddit: подборка примеров 1girl
- Reddit: Editing Beast
- Reddit: советы по редактированию
- Reddit: аутпейнтинг
- Reddit: инпейтинг альфа-канала
- Reddit: Qwen-Image 2.1 Fix v2.0
※ Эта статья подготовлена по официальной информации и открытым публикациям сообщества по состоянию на 4 октября 2026 года. Количество голосов на Reddit, инструменты вокруг модели и условия лицензии могут меняться.