Квантовал собственную LLM на 300 млн параметров и сравнил скорость и точность на CPU
Модель на 320 млн параметров для хорватского RAG, которую я сделал в предыдущей статье. Поскольку она рассчитана на работу на CPU, на этот раз я применил квантование и проверил, насколько её можно уменьшить и ускорить, а также насколько упадёт точность.
Сразу выводы.
- Q6_K — оптимальный вариант. Размер составляет 1/5 (254 МБ), генерация примерно в 4 раза быстрее, а точность такая же, как у исходной модели
- Q2_K ломается. Он быстрый, но даже на вопросах с ответом начинает отказываться: «ответа нет»
- Неожиданно, Q3_K_M оказался точнее Q4_K_M
Что было сделано
Модель, созданную в PyTorch, я преобразовал в формат, с которым может работать llama.cpp, часто используемый для инференса на CPU (GGUF), и сохранил в восьми вариантах точности.
- Экспортировал модель в том же формате, что и Qwen3, и преобразовал в GGUF
- Токенизатор у меня собственный, поэтому llama.cpp отказался преобразовывать его как «неизвестный токенизатор». Я сравнил правила разбиения на слова: они полностью совпали с Qwen2, поэтому зарегистрировал его как Qwen2 и продолжил
- Проверил, что преобразование корректно. Токенизация всех 160 текстов полностью совпала с версией PyTorch. На 20 вопросах я запускал генерацию с выбором наиболее вероятного слова на каждом шаге — и результаты также полностью совпали во всех 20 случаях
- Создал варианты от F16 до Q2_K с помощью
llama-quantize
Таким образом, F32 в таблице содержит то же самое, что и версия на PyTorch. Это базовый вариант для сравнения.
Методика измерений
- CPU — i7-13700K. GPU не использовался
- Настройки llama.cpp: 8 потоков для генерации и 16 потоков для загрузки текста (после тестов это оказалось самым быстрым вариантом)
- Для 100 оценочных вопросов × 4 типа контекста каждая модель отвечала 400 раз
- Абзац: абзац примерно на 100 токенов, содержащий ответ
- Длинный текст: текст примерно на 3 000 токенов, содержащий ответ (в него также добавлены нерелевантные статьи)
- Нет ответа (абзац / длинный текст): текст, не содержащий ответа. Верный отказ считался правильным результатом
- В предыдущей статье измерения проводились на 300 вопросах, поэтому цифры немного отличаются
Результаты: точность
| Формат | Размер | Правильно, абзац | Правильно, длинный текст | Отказалась, длинный текст | Выдумала ответ (нет ответа: абзац/длинный текст) | Точность после проверки |
|---|---|---|---|---|---|---|
| F32 (база) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
«Точность после проверки» — это доля правильных ответов после того, как программа проверила, действительно ли приведённая моделью цитата есть в тексте; если её там не было, ответ заменялся на «нет ответа».
- F16, Q8_0 и Q6_K почти не отличаются от базового варианта. Разница составляет лишь 1–2 вопроса
- Начиная с Q5_K_M ошибок не столько становится больше, сколько увеличивается число отказов. Похоже, при неуверенности модель отказывается — то есть сохраняет характер, которому её обучили в прошлый раз. Количество выдуманных ответов не выросло
- Q4_K_M хуже Q3_K_M. На длинных текстах: 37% против 48%. На 100 вопросах возможны колебания, но 11 пунктов — заметная разница. Причину я пока не исследовал
- Q2_K отказывается в 78% случаев на длинных текстах. Это уже фактически другая модель
Результаты: скорость
| Формат | Скорость генерации | Среднее время одного запуска |
|---|---|---|
| PyTorch fp32 (для справки) | абзац 14.6・длинный текст 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 с |
| F16 | 35.9 tok/s | 2.08 с |
| Q8_0 | 59.0 tok/s | 1.93 с |
| Q6_K | 73.1 tok/s | 1.33 с |
| Q5_K_M | 81.2 tok/s | 1.26 с |
| Q4_K_M | 89.1 tok/s | 1.10 с |
| Q3_K_M | 103.4 tok/s | 1.12 с |
| Q2_K | 119.9 tok/s | 1.07 с |
Показатели llama.cpp — средние по 400 запускам, объединяющим абзацы, длинные тексты и случаи без ответа. Показатели PyTorch были измерены в предыдущей статье.
- Скорость генерации почти обратно пропорциональна размеру. На CPU её определяет не столько вычисление, сколько скорость чтения весов из памяти, поэтому чем меньше модель, тем она быстрее
- Даже при одинаковом F32 llama.cpp быстрее PyTorch
- Однако ниже Q6_K время одного запуска уменьшается незначительно. При такой длине текста более важным становится время начального чтения текста
Видео: один и тот же вопрос по длинному тексту на CPU
Модели дали текст примерно на 3 200 токенов и спросили: «Когда вышла Need for Speed Heat?» Правильный ответ: 8 ноября 2019 года.
Запись велась одновременно с отрисовкой экрана в браузере, поэтому скорость в видео ниже, чем в таблице выше. Считайте её сравнением вариантов между собой.
| Формат | Скорость генерации в видео | До первого символа | Всего | Результат |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 с | 18.5 с | Верно |
| F32 | 14.2 tok/s | 2.8 с | 8.1 с | Верно |
| F16 | 25.9 tok/s | 3.5 с | 6.4 с | Верно |
| Q8_0 | 38.2 tok/s | 4.0 с | 5.9 с | Верно |
| Q6_K | 41.6 tok/s | 2.6 с | 4.4 с | Верно |
| Q5_K_M | 46.3 tok/s | 2.6 с | 4.3 с | Верно |
| Q4_K_M | 47.2 tok/s | 2.3 с | 4.7 с | Верно (ответ длиннее) |
| Q3_K_M | 56.7 tok/s | 2.5 с | 4.5 с | Верно (ответ длиннее) |
| Q2_K | 61.3 tok/s | 2.7 с | 2.8 с | Отказалась |
От F32 до Q5_K_M и ответ, и цитата полностью совпали с версией PyTorch. У Q4_K_M и Q3_K_M текст ответа стал длиннее, но цитаты были верными. Q2_K отказалась, заявив «в тексте нет ответа», хотя ответ был.
PyTorch fp32 (исходная модель)
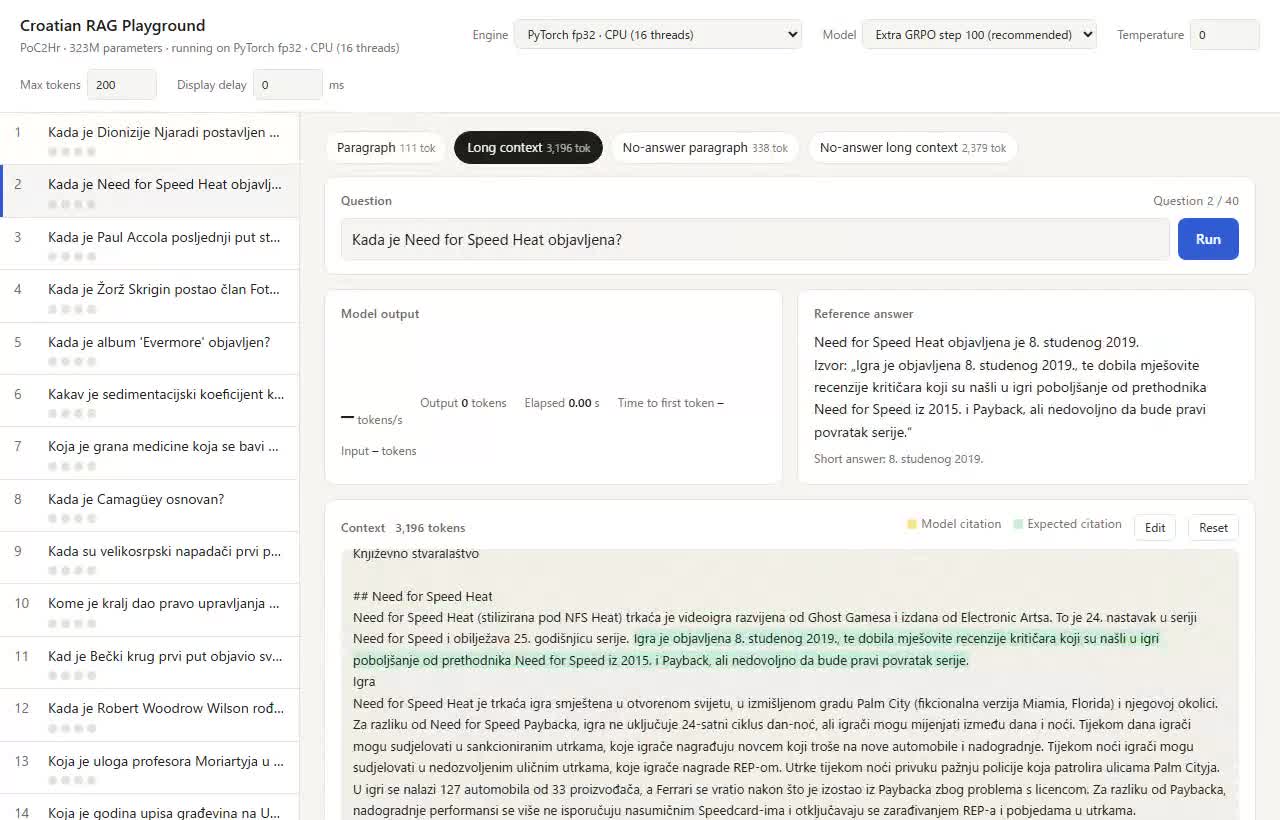
llama.cpp F32 (1,233MB)
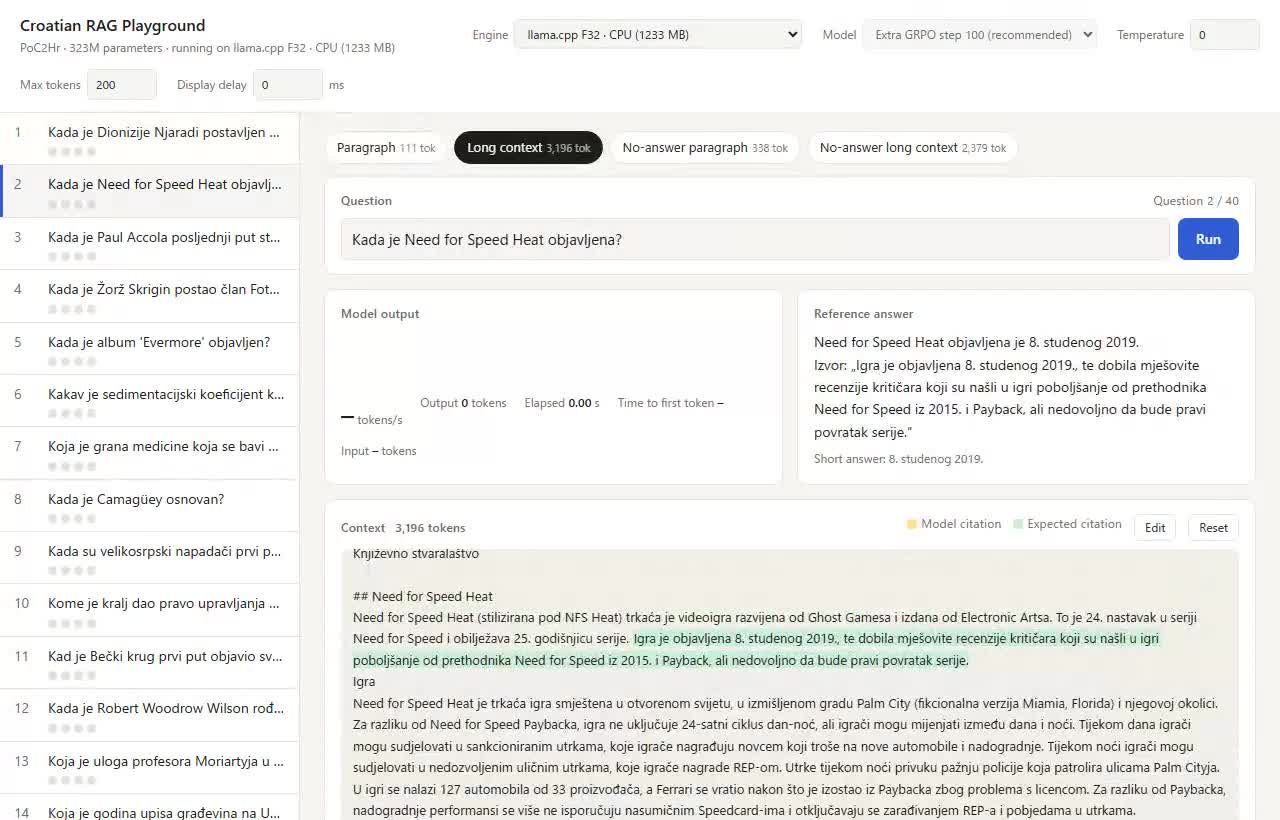
llama.cpp F16 (617MB)
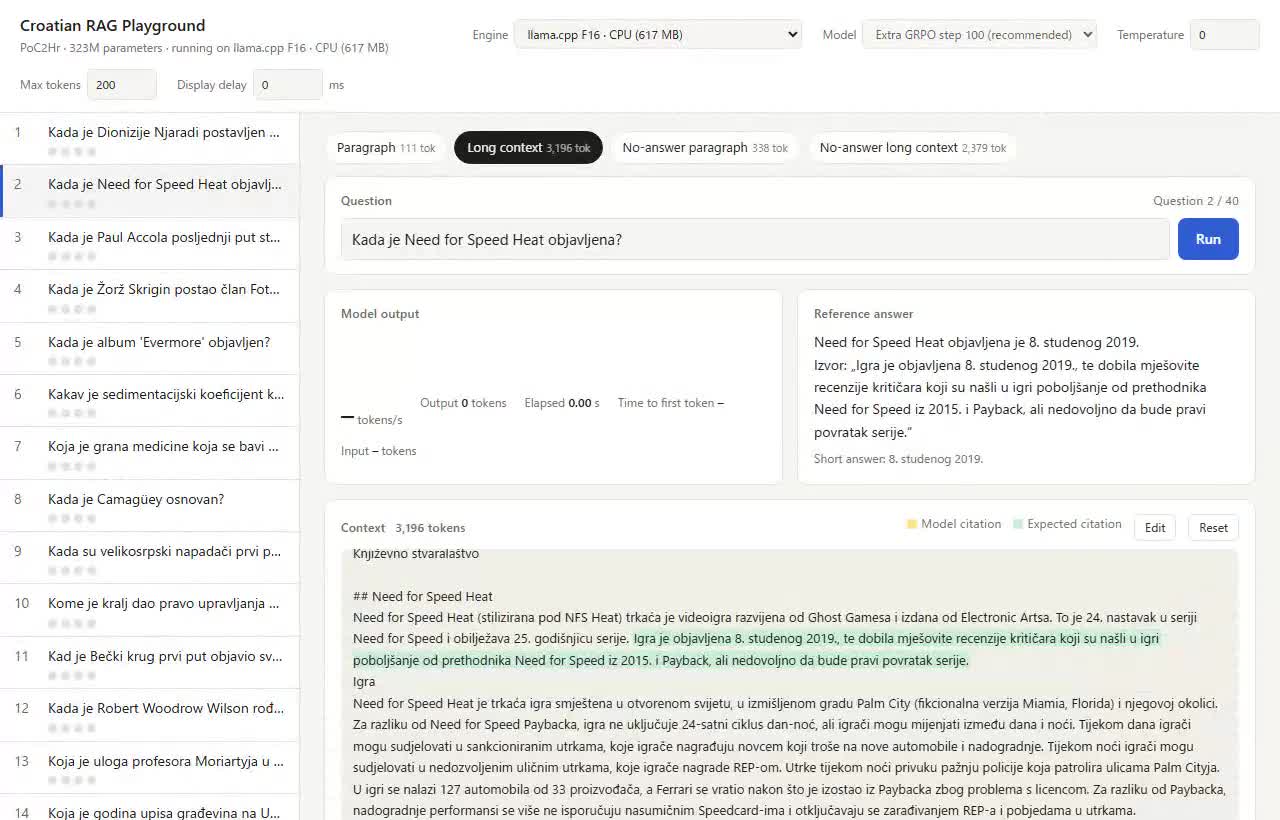
llama.cpp Q8_0 (329MB)
llama.cpp Q6_K (254MB)
llama.cpp Q5_K_M (223MB)
llama.cpp Q4_K_M (193MB)
llama.cpp Q3_K_M (160MB)
llama.cpp Q2_K (129MB)
Выводы
- Для работы этой модели на CPU стоит выбрать Q6_K. Точность остаётся исходной, размер — 1/5, а генерация примерно в 5 раз быстрее PyTorch. Причин сомневаться нет
- Если хочется большей уверенности, выбирайте Q8_0. Он почти не отличается от исходной модели и занимает 329 МБ. Это всё равно достаточно мало
- Маленькие модели на 300 млн параметров чувствительны к квантованию. Говорят, что у больших моделей даже Q4 почти не ухудшает качество, но здесь заметное падение началось уже с Q5. У модели и так небольшой запас, поэтому сокращение весов сильно сказывается
- Хорошо, что модель ломается в сторону отказов. Для RAG безопаснее отказаться, чем начать выдумывать ответы. Здесь также проявился эффект обучения отказам с подкреплением, проведённого в прошлый раз
- У небольших моделей разница в скорости сглаживается. Ниже Q6_K, даже если генерация ускоряется, остаётся время на чтение текста, поэтому субъективная скорость почти не меняется. В видео Q6_K–Q3_K_M все уложились примерно в 4 секунды
- Почему Q4_K_M уступил Q3_K_M, пока неизвестно. Хочется увеличить число вопросов и изучить, какие именно слои и как квантуются