Попробовал использовать превиз для генерации AI-видео. Пусть грубый, но он нужен
Я попробовал передать AI-генератору видео простой превиз, сделанный из коробок и манекенов. Превиз — это черновое видео, в котором заранее задаются расположение и движения персонажей, а также работа камеры.
Если сразу перейти к выводу: это вполне рабочий подход. Правда, мелкие детали не воспроизводятся в точности. Скорее, когда задаёшь общую режиссуру, AI удачно дополняет недостающие элементы. В качестве чертежа для этого превиз оказался очень удобен.
Сравнение превиза и результата генерации
Во всех видео сверху — ролик, сгенерированный AI, снизу — исходный превиз. Каждое длится около 15 секунд. Я проверяю, насколько можно передать ход сцены, не прорабатывая фон и персонажей.
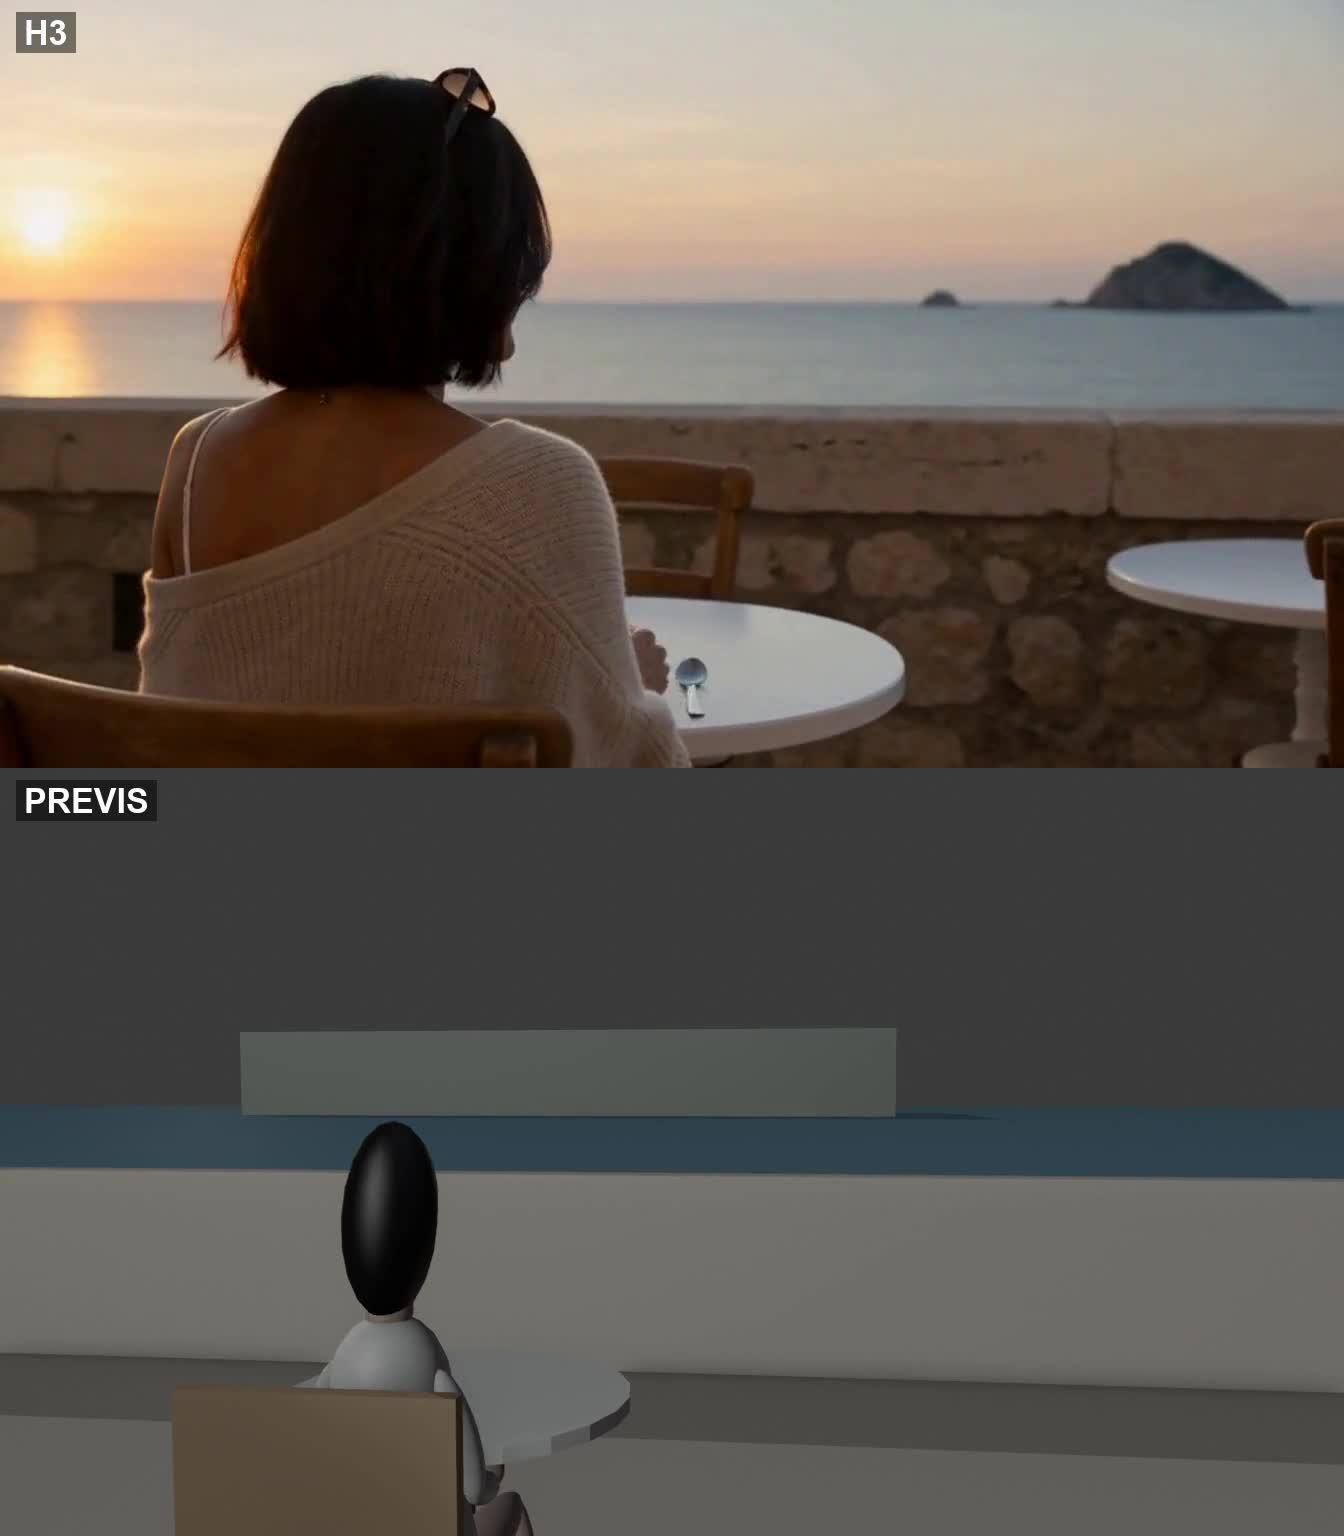
Кафе у моря
Из простого расположения стола и персонажей получилось кафе в сумерках. Такие движения, как поднесение напитка ко рту, превращены в видео в стиле живой съёмки.
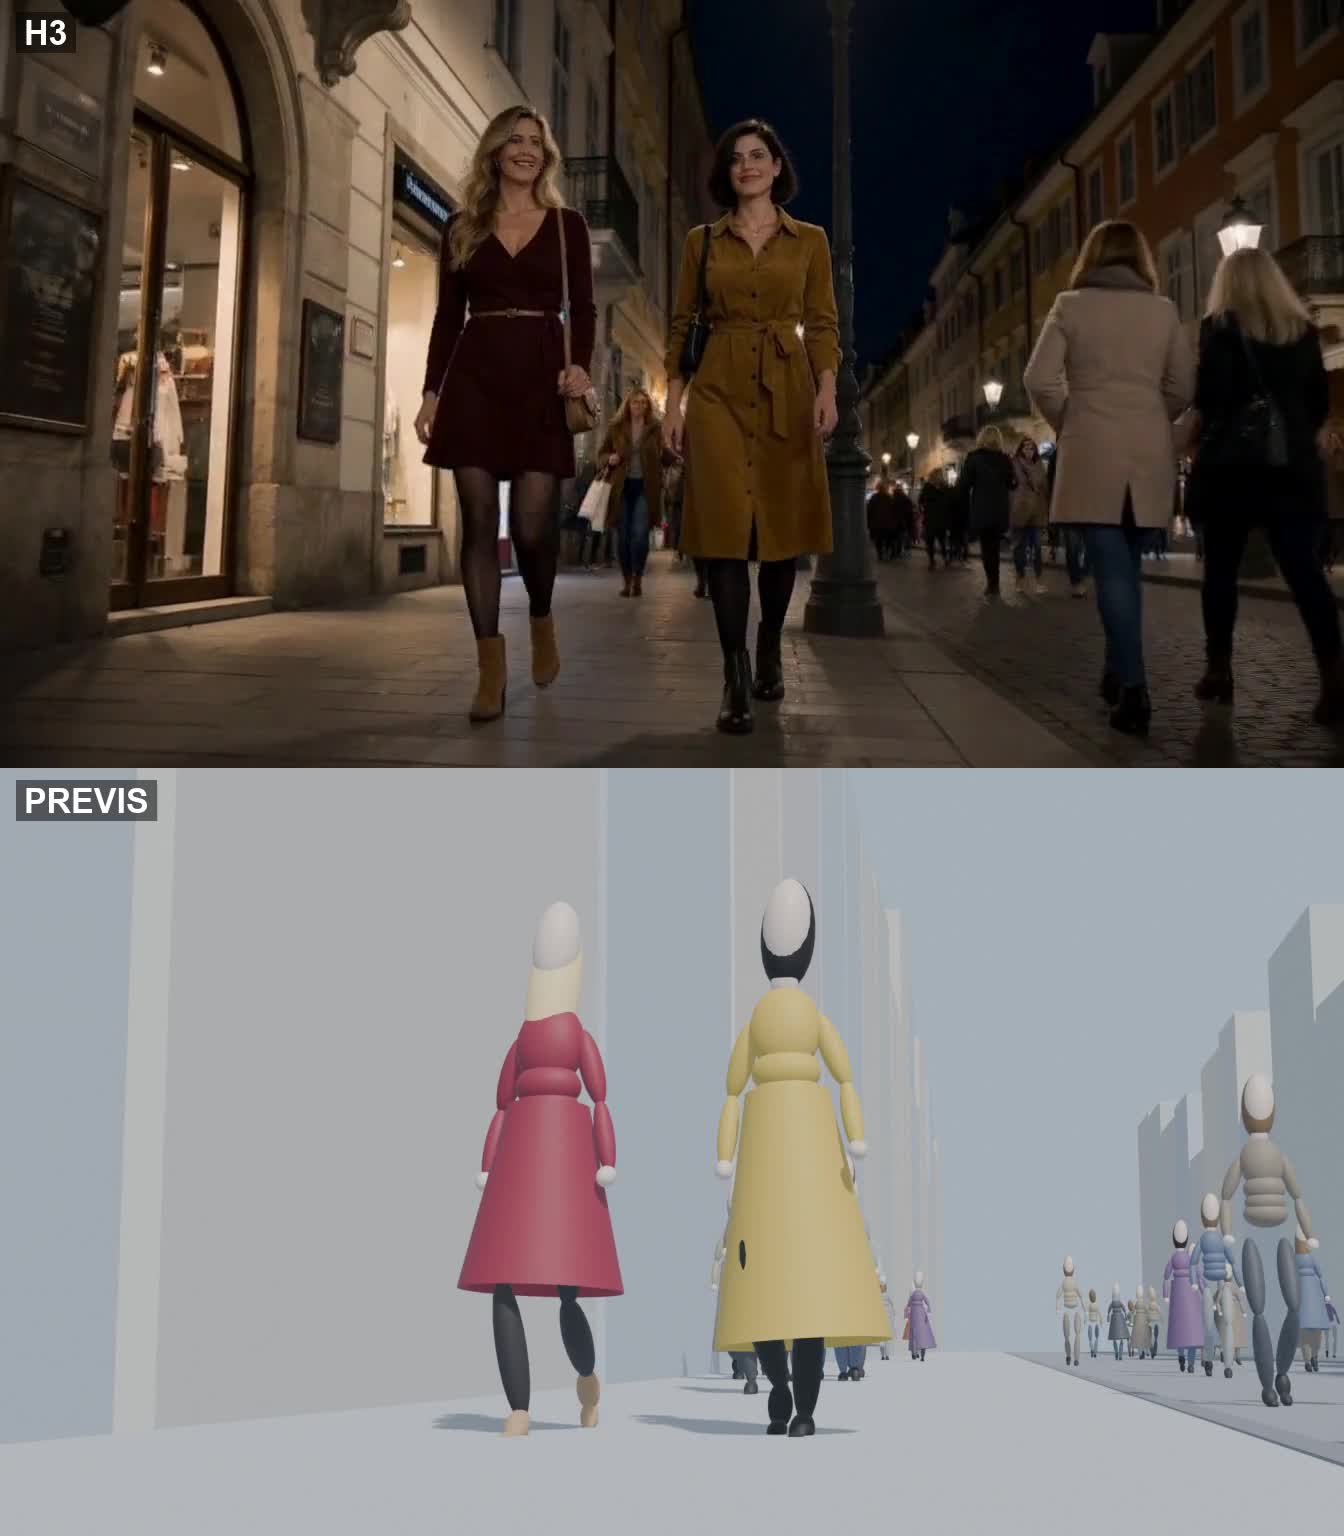
Прогулка по ночному городу
В превизе заданы положение персонажа и направление ходьбы. Упрощённый яркий городской пейзаж, почти как днём, с помощью промпта превращён в ночной город.
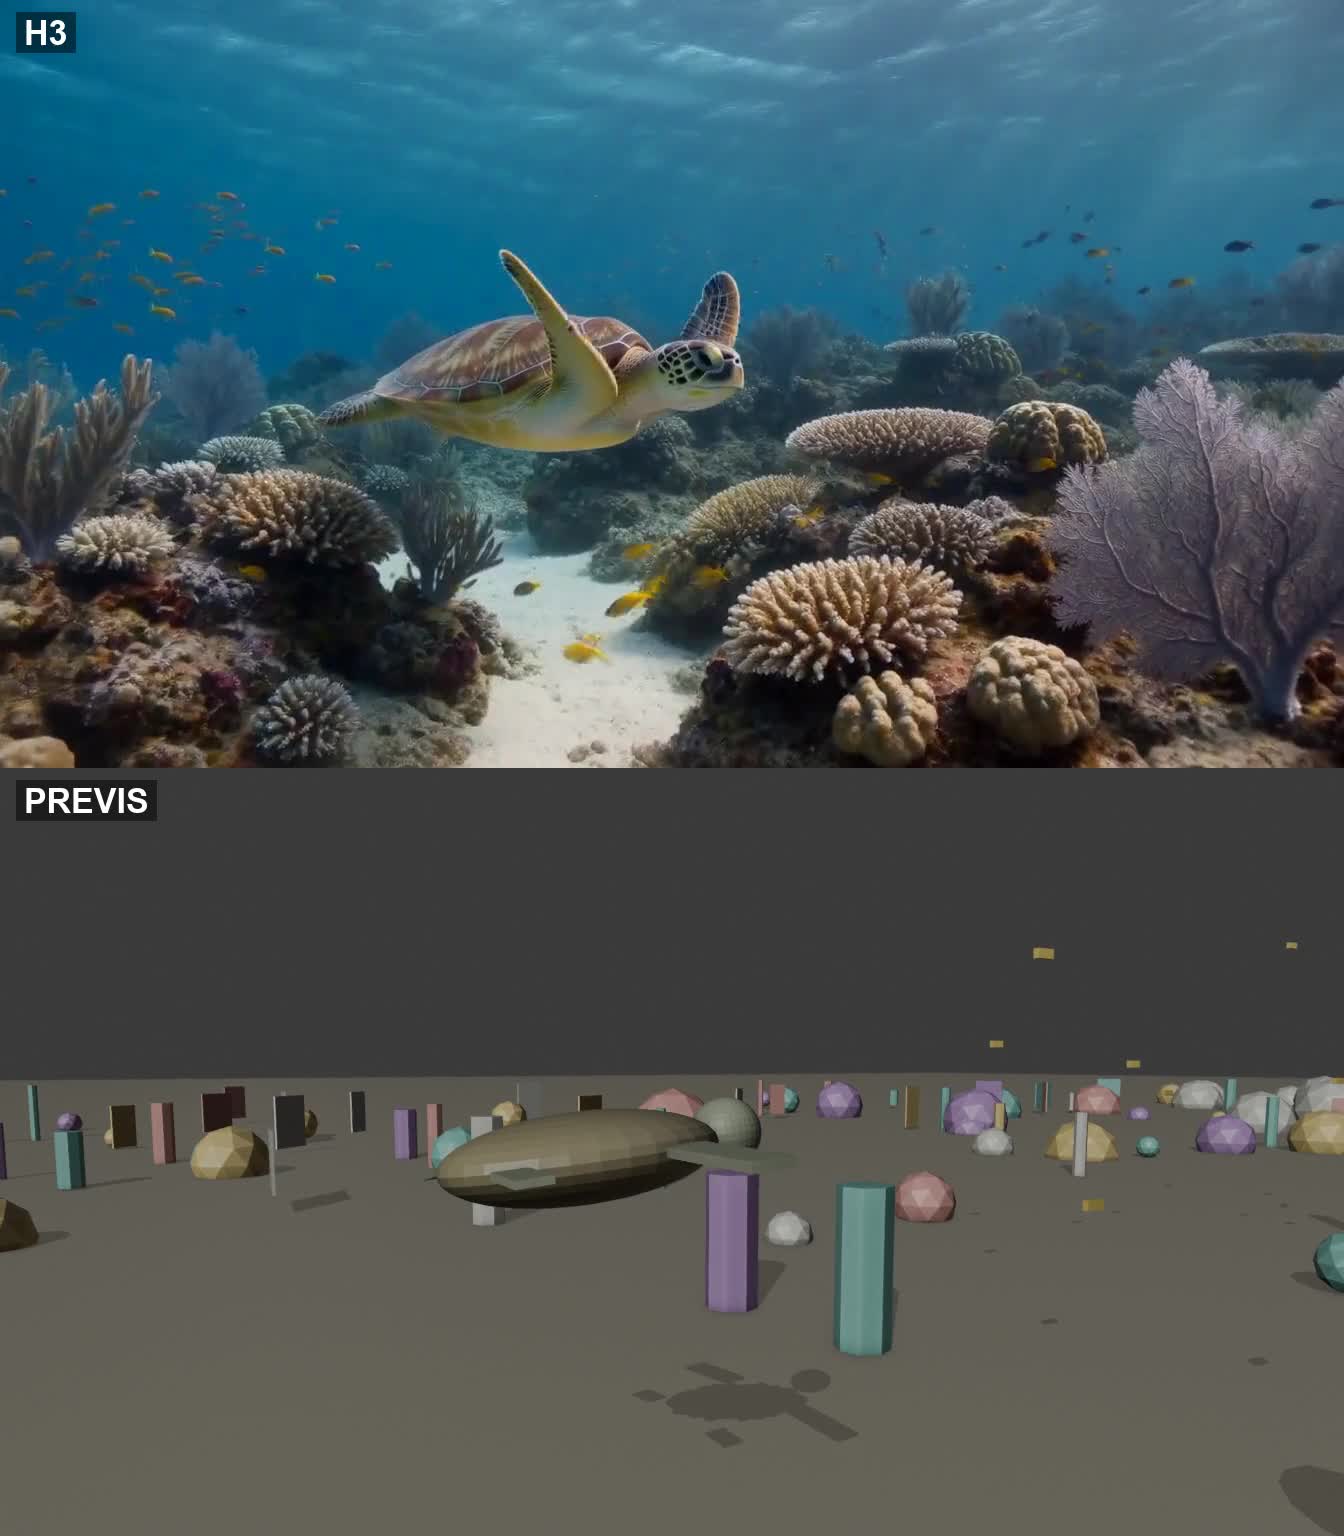
Морская черепаха под водой
Из схематичного морского дна и движения черепахи получился подводный пейзаж со светом в воде и кораллами. Это наглядный пример визуального дополнения.
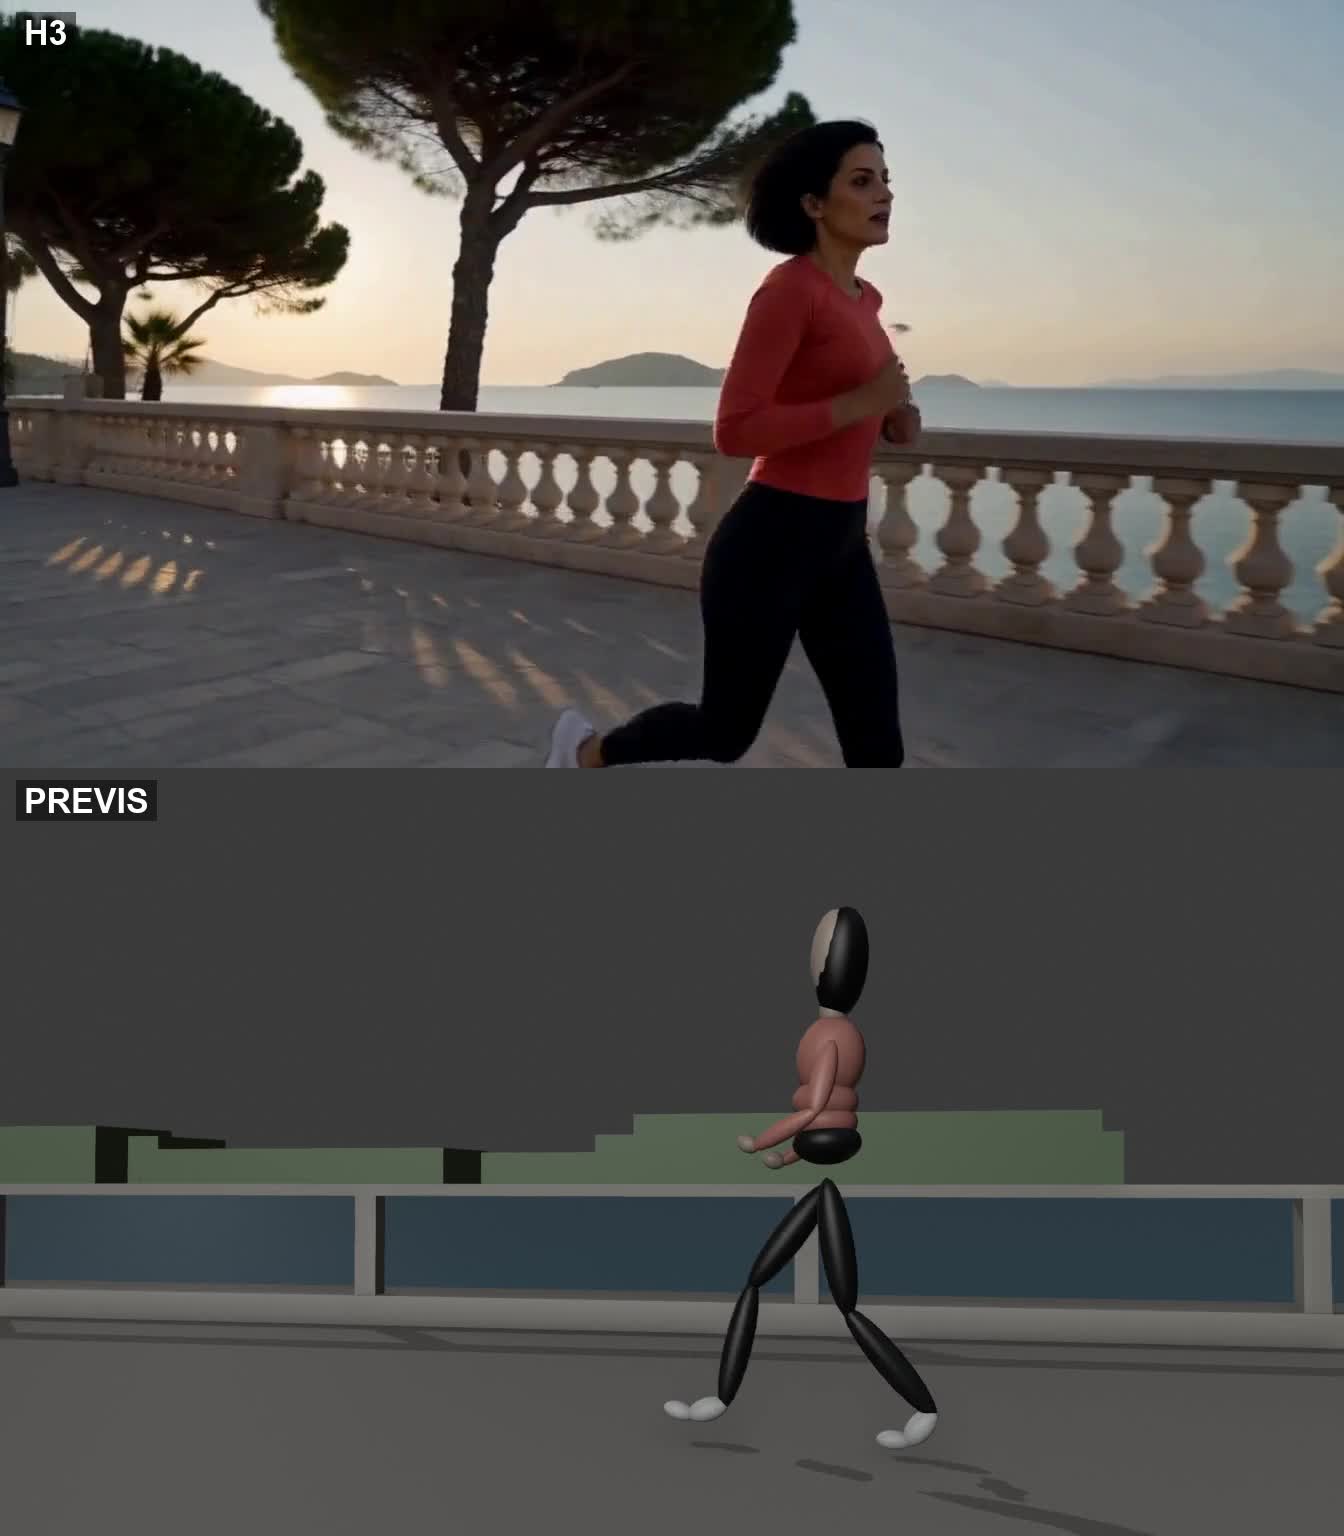
Бег вдоль моря
Заданы бегущий персонаж и движение следующей за ним камеры. Черновой фон заменён на приморскую прогулочную дорожку.
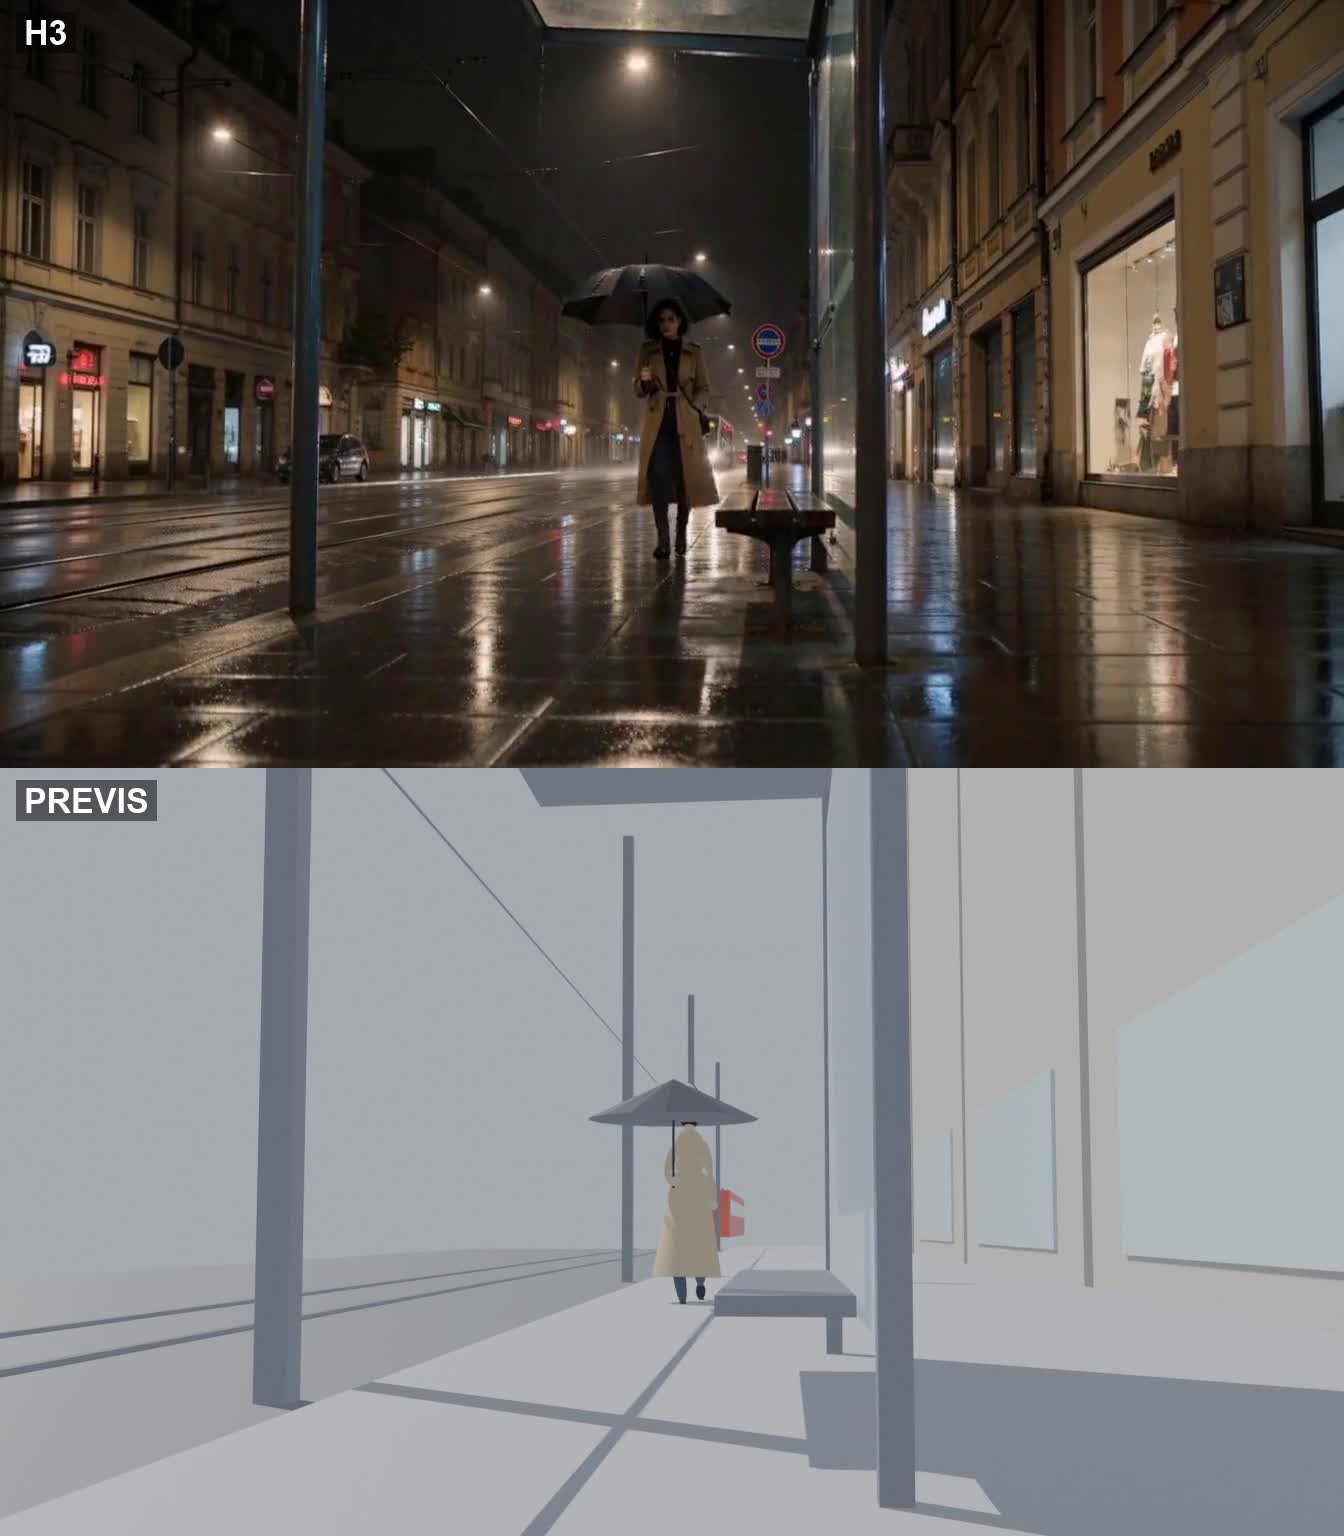
Дождливый город и трамвай
На основе расположения персонажа с зонтом и трамвая добавлена атмосфера дождливой ночи.
Процесс создания прост
В этот раз работа шла так.
- В Python+Blender 4.2 создаётся превиз из коробок и простых форм. Для анимации персонажей также используется Mixamo.
- В генераторе изображений Codex подготавливаются референсные изображения персонажей и других элементов.
- В MiniMax-H3 Ref2VA передаются превиз, референсные изображения и референсный звук, после чего генерируется видео примерно на 15 секунд.
- Реплики создаются в HiggsAudio v3, звуковые эффекты — в Stable Audio 3 Medium, а BGM — в ACE-Step 1.5; затем всё сводится и монтируется в ffmpeg. Для производственных скриптов и управления их запуском использовался Claude Code.
Главное в инструкциях — разделить роли референсов. Нужно указать, что «изображения отвечают за лица и костюмы», а «превиз — за расположение, действия и движения камеры», и отдельно попросить не переносить внешний вид манекенов и коробок. Ночь, дождь, освещение и прочие финальные детали задаются текстом.
Работает, но детали заметно меняются
Расположение персонажей, направление движения, последовательность действий и общий характер движения камеры передаются достаточно хорошо. Но тонкие указания вроде «остановиться через столько-то секунд» или «насколько приблизить камеру» могут смещаться или вовсе не учитываться. Жёстко зафиксировать детали не получится.
Кроме того, в результате иногда сохранялось мерцание освещения из превиза или слишком регулярная компоновка фона. Похоже, в превизе лучше максимально упростить и свет, и формы, сосредоточившись на движении, которое нужно передать.
И всё же способность дополнить грубое описание эффектным видео очень удобна. Детали могут заметно измениться, но для передачи общего замысла постановки этого вполне достаточно. Не нужно доводить превиз до совершенства: пусть он будет грубым, но использовать его всё же стоит — такой вывод я сделал по итогам этого эксперимента.